RLHF — Partiamo dal reinforcement learning
Primo di una serie di appunti su RLHF — Reinforcement Learning from Human Feedback.
Ho deciso di iniziare a informarmi su questo argomento dopo essermi posto una domanda: cosa rende i moderni modelli di linguaggio così efficaci nell’interazione con gli esseri umani?
Durante il mio percorso universitario ho avuto a che fare con LLM di dimensioni relativamente piccole — il mio amico Llama 3 8B — ma, usandolo, mi sono accorto di quanto le risposte che generava fossero lontane da quelle dei grandi modelli di OpenAI o Anthropic. Non tanto perché il testo fosse necessariamente pessimo (non stiamo a discutere sulla qualità di un modello «tiny» rispetto ad uno di frontiera), quanto per quella sensazione quasi «umana» che si percepisce interagendo con i modelli più avanzati.
Ho scoperto così che una parte sorprendentemente importante del comportamento che associamo ai moderni assistant viene costruita durante il post-training, attraverso tecniche tra cui il RLHF.
Cercherò quindi di scoprire, uno step alla volta, gli arcani che si celano dietro a queste tecniche e di capire da dove arrivi qualcosa che, visto dall’esterno, sembra quasi spettacolare.
Il riferimento principale di questo percorso sarà il libro di Nathan Lambert. Con questi post non ho alcuna intenzione di sostituire quanto scritto dall’autore: cercherò piuttosto di rielaborarne i concetti, insieme a ciò che incontrerò lungo il percorso, così da costruirmi una serie di appunti a cui poter tornare in futuro.
Se stai leggendo e non ti chiami Andrea Vannozzi, spero che possano tornare utili anche a te.
Il problema: decidere in sequenza
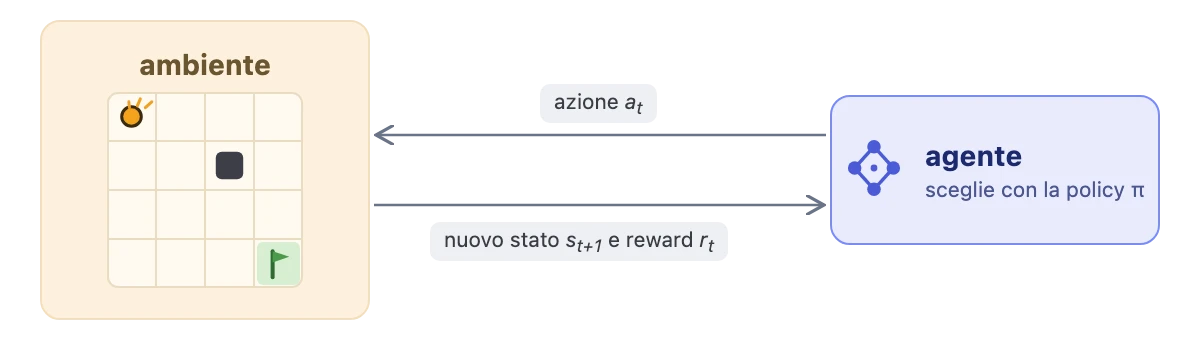
Partiamo da un esempio che useremo per tutto il post. Una piccola griglia: in una cella c’è un agente, in un’altra una bandiera, in mezzo una parete. A ogni turno l’agente può muoversi su, giù, a sinistra o a destra; se va contro la parete resta dov’è. La partita, che chiameremo episodio, finisce quando l’agente raggiunge la bandiera oppure quando esaurisce le mosse a disposizione. Nessuno gli dice quale strada prendere: alla fine saprà solo se è arrivato.
Il reinforcement learning (RL) è una classe di metodi per compiti di questo tipo: si impara a scegliere da un segnale che valuta i risultati, non da esempi della scelta giusta. Spesso le decisioni sono in sequenza, e ogni scelta cambia le situazioni e le possibilità future: una mossa sbagliata all’inizio può allungare tutto il percorso.
Diamo un nome ai pezzi. L’entità che sceglie si chiama agente; ciò con cui interagisce si chiama ambiente. Lo stato è l’informazione che descrive la situazione corrente, qui la posizione dell’agente nella griglia. Un’azione è una delle scelte disponibili, per esempio «destra». La ricompensa, o reward, è il numero che l’ambiente restituisce dopo un’azione: per esempio +1 quando una mossa porta l’agente sulla bandiera e 0 altrimenti.
Ora i simboli. Il tempo avanza a passi discreti, indicati con : è il primo passo, il successivo, e così via. Non è una durata in secondi, solo un indice. Al passo l’agente si trova nello stato e sceglie un’azione secondo una policy, indicata con . Qui consideriamo una policy stocastica, che assegna una probabilità a ciascuna azione. La scrittura si legge «la probabilità che la policy scelga l’azione dato lo stato »: la barra verticale significa «dato». Per esempio, in una certa cella la policy può assegnare 0,7 a «destra» e 0,3 a «su».
L’ambiente risponde all’azione con un nuovo stato, secondo una dinamica di transizione : la probabilità che il prossimo stato sia , dato lo stato corrente e l’azione . Anche questa è una distribuzione: se la griglia è scivolosa, «destra» può portare nella cella a destra nel 90% dei casi e far scivolare l’agente altrove nel restante 10%. Le due distribuzioni hanno ruoli diversi: descrive il comportamento dell’agente, ed è ciò che si vuole imparare; descrive le regole dell’ambiente, che l’agente non controlla.
Insieme al nuovo stato arriva il reward. Per tenere semplice la notazione assumeremo che dipenda solo dallo stato e dall’azione, e lo scriveremo : il reward ricevuto dopo l’azione del passo . In generale può dipendere anche dal nuovo stato: nella griglia scivolosa la stessa mossa può arrivare o no sulla bandiera. Conviene anche dire subito che cosa il reward non è. È il numero che l’algoritmo tratta come misura della qualità di un esito, non necessariamente una descrizione perfetta di ciò che vogliamo ottenere. Se la misura è imperfetta, l’agente impara a massimizzare la misura, non l’intenzione: è un tema che tornerà con forza quando il reward verrà da un modello appreso.
C’è infine un’ipotesi nascosta nella scrittura : per descrivere il passo successivo bastano lo stato e l’azione correnti, e la storia precedente non aggiunge nulla. È la proprietà di Markov, e un problema descritto così si chiama processo decisionale di Markov, o MDP (Markov Decision Process). Non è una verità automatica: vale se lo stato contiene tutta l’informazione che serve. In questo post assumiamo anche che l’agente osservi lo stato per intero.
Il ciclo, in sintesi, è questo: l’agente legge lo stato, la policy sceglie un’azione, l’ambiente riceve l’azione e restituisce un nuovo stato e un reward, e il nuovo stato diventa il punto di partenza della decisione successiva.
Un caso limite ci servirà più avanti. Se l’episodio consiste in una sola decisione, cioè si osserva un contesto, si sceglie, si riceve il reward e si ricomincia da capo, il problema si chiama bandit contestuale. È ancora reinforcement learning, perché si impara da un segnale valutativo, ma senza una catena di stati successivi. Lo ritroveremo nei prossimi post, perché è uno dei modi di descrivere la risposta di un modello di linguaggio.
Feedback istruttivo e feedback valutativo
Qui sta una delle differenze che contano rispetto all’apprendimento supervisionato (supervised learning), ed è una delle ragioni per cui l’RL è un campo a sé.
Nell’apprendimento supervisionato ogni esempio di addestramento contiene anche l’uscita desiderata, detta target o etichetta: una delle risposte valide, che il modello deve imparare a produrre o a imitare. Confrontando la sua uscita con l’etichetta si calcola un errore, e l’addestramento usa quell’errore per aggiornare il modello. È un feedback istruttivo: non dice solo che hai sbagliato, dice anche che cosa avresti dovuto rispondere.
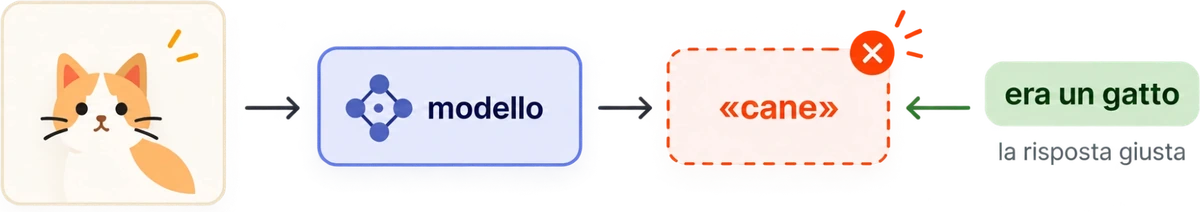
Nel reinforcement learning, invece, l’ambiente restituisce un reward: un numero che valuta ciò che è successo, senza specificare quale azione sarebbe stata quella corretta. È un feedback valutativo.
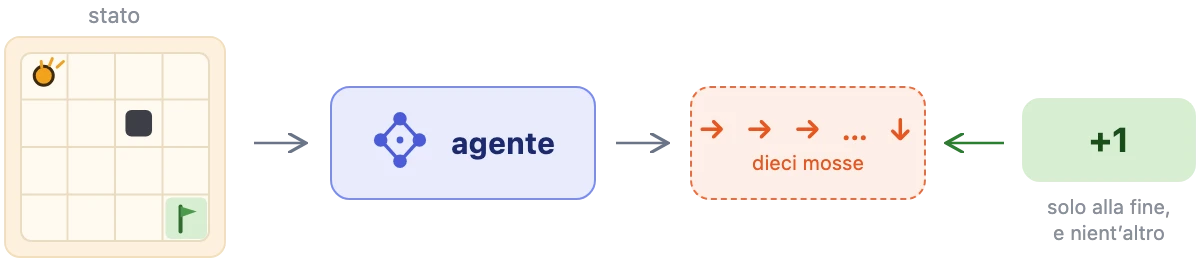
Nella griglia l’agente fa dieci mosse e riceve +1: l’episodio è riuscito. Ma il +1 non dice quali delle dieci mosse siano state decisive e quali inutili. Il reward può essere denso, con un segnale informativo a ogni passo, oppure sparso, come qui, dove tutti i passi intermedi valgono zero e l’unico segnale arriva alla fine.
Da qui nascono due problemi che torneranno di continuo. Il primo è stabilire quali azioni di una sequenza abbiano contribuito al reward, soprattutto quando il segnale arriva in ritardo: è l’attribuzione del merito (credit assignment). Il secondo nasce perché il reward non indica le alternative: se l’agente impara interagendo con l’ambiente, per scoprire se esistono strade migliori deve provarle. Deve quindi scegliere fra raccogliere informazioni provando azioni nuove e sfruttare ciò che sembra già funzionare: è il compromesso fra esplorazione e sfruttamento (exploration–exploitation).
Un esame in cui il professore restituisce solo il voto, mai il compito corretto: quali passaggi ti abbiano fatto guadagnare o perdere punti devi capirlo da solo.
La distinzione, detta così, è un ideale didattico: nella pratica i due tipi di segnale si combinano spesso, e lo vedremo proprio nell’RLHF. Buona parte del reinforcement learning nasce dal tentativo di trasformare un feedback valutativo in un comportamento migliore.
La traiettoria
Per valutare una policy non basta guardare una singola azione: bisogna considerare l’intera sequenza prodotta durante un episodio. Un episodio è un’interazione completa, dall’inizio alla fine; finisce in uno stato terminale, come la cella della bandiera, oppure quando si raggiunge l’orizzonte, il numero massimo di decisioni previste. Indichiamo con il numero di azioni di un episodio finito: le azioni vanno da ad , gli stati da a . Ci sono quindi azioni e stati, perché l’ultimo stato chiude l’episodio senza un’azione successiva.
Una singola esecuzione dell’agente produce la sequenza
che si chiama traiettoria. I reward non compaiono esplicitamente perché, con la semplificazione adottata, si ricavano da stati e azioni con .
Anche seguendo la stessa policy, esecuzioni diverse possono produrre traiettorie diverse: lo stato iniziale può cambiare, le azioni vengono campionate dalla policy e l’ambiente può reagire in modo casuale. Campionare significa estrarre una scelta a caso secondo una distribuzione di probabilità: un’azione con probabilità 0,7 viene scelta spesso, ma non sempre.
Possiamo però descrivere la distribuzione delle traiettorie, cioè con quale probabilità ciascuna venga generata seguendo una certa policy:
Leggiamola pezzo per pezzo. è la probabilità dell’intera traiettoria quando si segue , da non confondere con , che descrive una singola transizione dell’ambiente. è la probabilità di partire proprio dallo stato . Il simbolo indica un prodotto ripetuto per ogni passo, da a , cioè per ciascuna delle azioni; a ogni passo si moltiplicano la probabilità dell’azione scelta dall’agente e quella della transizione prodotta dall’ambiente. Si moltiplica perché ogni fattore è la probabilità di un passo dato tutto ciò che è successo prima, e grazie alla proprietà di Markov quel «tutto ciò che è successo prima» si riduce allo stato e all’azione correnti.
Un esempio con due passi. Si parte sempre dallo stesso stato, quindi ; la prima azione ha probabilità 0,8 e la sua transizione 0,9; la seconda azione ha probabilità 0,6 e la sua transizione è certa. La traiettoria ha probabilità . A questo serve la distribuzione: stabilisce con quale peso ciascuna traiettoria conta nella media che vedremo tra poco.
Dal ritorno di una traiettoria alla prestazione della policy
Abbiamo il reward di un singolo passo. Per giudicare un episodio intero servono due ingredienti in più.
Il primo è il fattore di sconto , un numero con che stabilisce quanto contano le ricompense future rispetto a quelle immediate: il reward ricevuto passi più avanti viene moltiplicato per . Con vicino a 0 l’agente vive nell’istante; con tutti i reward contano allo stesso modo.
Il secondo è il ritorno (return): la somma, scontata con , dei reward osservati da un certo passo fino alla fine dell’episodio. Dal passo in poi:
Il simbolo indica una somma: scorre da a , l’ultimo passo con un’azione, e il reward del passo viene moltiplicato per , cioè elevato al numero di passi che separano da . è un numero concreto, osservato in una specifica esecuzione: un’altra esecuzione della stessa policy può dare un ritorno diverso. è il ritorno dell’intero episodio. Nella griglia, con reward +1 solo alla bandiera e , vale 1 se l’agente arriva e 0 altrimenti.
Un esempio numerico per . Con un reward immediato pesa 1, uno che arriva un passo dopo pesa 0,9, uno che arriva dieci passi dopo pesa circa 0,35: «vicino a 1» non vuol dire che il peso resti quasi uguale per sempre.
Perché introdurre ? Ci sono due idee che conviene tenere separate.
- Convergenza della somma. Su un orizzonte infinito la somma dei reward potrebbe non essere finita. Se i reward sono limitati e , lo sconto garantisce un ritorno finito.
- Preferenza temporale. Usare significa decidere che una ricompensa ricevuta prima vale più della stessa ricompensa ricevuta dopo. È una proprietà dell’obiettivo che abbiamo scelto, non una necessità del reinforcement learning.
Su un orizzonte finito, infatti, nulla ci obbliga a scontare il futuro: possiamo porre semplicemente .
Il ritorno di una singola esecuzione dipende anche dalla fortuna. Per giudicare la policy serve la media su tutte le traiettorie che può produrre, pesate dalla (1). Questa media si chiama prestazione attesa della policy:
indica il valore atteso, cioè la media teorica sui possibili esiti; si legge « estratta dalla distribuzione », cioè fra le traiettorie generate dalla policy. In una frase: è il ritorno che la policy ottiene in media.
Il problema dell’RL diventa allora trovare
Il simbolo restituirebbe il valore più alto di ; invece restituisce l’argomento che lo produce, qui la policy. L’asterisco indica per convenzione un oggetto ottimo, e si scrive «appartiene a» perché possono esistere più policy ugualmente buone: è una policy ottima.
Nei sistemi grandi o sconosciuti che ci interessano, non si può calcolare esattamente: le traiettorie possibili sono troppe e la dinamica dell’ambiente può essere ignota. Quello che si può fare è eseguire la policy più volte, raccogliere gli episodi e usare la media dei loro ritorni come stima.
Tre quantità collegate ci serviranno per capire come si migliora una policy. Tutte usano il ritorno atteso, ma partendo da punti diversi:
Qui è la media sulle traiettorie generate dalla policy, considerando solo quelle che al passo si trovano nello stato . La funzione di valore dice quanto è promettente lo stato : il ritorno atteso partendo da lì e seguendo la policy. La funzione azione-valore dice quanto è promettente una specifica azione in quello stato: il ritorno atteso se si sceglie prima e poi si segue la policy. L’advantage è la differenza: quanto quell’azione è migliore o peggiore della scelta media della policy. Li ritroveremo più avanti nel critico, la rete che stima mentre un modello di linguaggio scrive.
Migliorare la policy
Saper valutare una policy non basta: lo spazio delle policy possibili è troppo grande per provarle tutte. Serve un modo per partire dalla policy che abbiamo e capire come modificarla per renderla migliore.
Quando la policy è una rete neurale, il suo comportamento dipende da un insieme di numeri, i parametri, che indichiamo con ; scriviamo allora la policy come . Migliorarla significa cambiare in modo che cresca. Il problema generale si chiama policy optimization. Una famiglia di metodi per affrontarlo è quella dei policy gradient: a partire dalle traiettorie raccolte, stimano in quale direzione spostare i parametri per aumentare il ritorno atteso. In pratica rendono più probabili le azioni andate meglio del previsto, con advantage positivo, e meno probabili quelle andate peggio. PPO, Proximal Policy Optimization (Schulman e colleghi), è uno specifico algoritmo di questa famiglia: limita l’ampiezza dei singoli aggiornamenti, per non cambiare la policy troppo bruscamente prima di raccogliere nuove traiettorie. Come funzionino in concreto lo vedremo più avanti.
Dal reinforcement learning ai modelli di linguaggio
Tutto questo presuppone che il reward esista e sia misurabile. In alcuni problemi è relativamente semplice definirlo: in una partita a scacchi si può assegnare +1 alla vittoria, 0 al pareggio e −1 alla sconfitta, al termine della partita. Anche qui qualcuno ha deciso quel numero, ma la scelta è quasi obbligata; e come nella griglia il segnale arriva solo alla fine, con tutto il problema dell’attribuzione del merito.
Con un modello di linguaggio le cose cambiano. Alcuni compiti hanno ancora una verifica automatica: un problema con una risposta controllabile, un programma che deve superare dei test. Ma per le qualità aperte che rendono buono un assistente — essere utile, onesto e non dannoso, la terna che in inglese si dice helpful, honest, harmless — non c’è nessun numero da leggere direttamente nell’ambiente.
Prima di affrontare questo problema, vediamo come si traducono gli oggetti di questo post:
- lo stato è il prompt, cioè il testo di ingresso, insieme ai token della risposta già generati; un token è un’unità del vocabolario del modello, una parola o un pezzo di parola;
- l’azione è la scelta del token successivo;
- la policy è il modello stesso, che assegna una probabilità a ogni token del vocabolario;
- l’episodio è la generazione di una risposta, dal prompt fino alla fine, e la traiettoria è la risposta prodotta;
- il reward è un punteggio assegnato alla risposta.
C’è una sottigliezza che conviene anticipare. A livello di token la risposta è una lunga sequenza di decisioni. A livello di risposta completa, invece, prompt, risposta e valutazione si possono trattare come un episodio di un solo passo, cioè come un bandit contestuale. Le due viste descrivono la stessa cosa, e il prossimo post le mette a confronto.
Resta la domanda vera: se la qualità di una risposta non è già un numero, come si trasformano le preferenze umane in un segnale che l’algoritmo possa usare? Lo vediamo nel prossimo post, Adattare il reinforcement learning ai modelli di linguaggio.