RLHF — Adattare il reinforcement learning ai modelli di linguaggio
Nel primo post abbiamo visto il reinforcement learning (RL), cioè l’apprendimento guidato da un segnale di ricompensa, spesso in compiti a decisione sequenziale: un agente sceglie azioni, l’ambiente risponde con nuovi stati e ricompense, e nessuno fornisce in anticipo la sequenza corretta di azioni.
Il reinforcement learning from human feedback (RLHF) applica la stessa idea ai modelli di linguaggio, usando giudizi umani per costruire la ricompensa. In questo post uso il termine in senso stretto: un reward appreso dalle preferenze umane, e poi un algoritmo di RL che ottimizza il modello contro quel reward. Spesso «RLHF» indica anche, in senso più ampio, tutto il post-training basato sulle preferenze, cioè l’addestramento che segue il pretraining; quando serve lo dirò. E considero la formulazione resa canonica da lavori come InstructGPT: un prompt, una risposta, un reward, e l’episodio finisce. Altre forme di RLHF, come i dialoghi a più turni o gli agenti che usano strumenti, hanno interazioni più lunghe.
Rispetto a molti esempi introduttivi di RL, in cui l’agente parte da una policy casuale o poco competente, la situazione cambia soprattutto su un punto: non si parte da zero. Il modello di linguaggio arriva dal pretraining, l’addestramento iniziale su enormi quantità di testo, e ha già appreso regolarità linguistiche, molta informazione sul mondo e diverse abilità utili. Nelle pipeline considerate qui, l’effetto principale dell’RLHF è rendere più accessibili e frequenti comportamenti che il pretraining ha già reso possibili. In gergo si dice che fa soprattutto elicitation, cioè rende probabile una capacità latente, più che acquisition, cioè l’apprendimento di una capacità che prima mancava. È un’intuizione utile, non una legge: il post-training modifica i pesi e può insegnare anche strategie e convenzioni nuove, e il confine fra le due cose resta discusso.
La pipeline, vista dall’alto, ha cinque passi:
- si parte da un modello pre-addestrato;
- lo si addestra su esempi di risposte scritte da persone;
- si generano risposte candidate e si raccolgono le preferenze umane fra di esse;
- con quelle preferenze si addestra un modello che assegna un punteggio alle risposte;
- si ottimizza il modello di linguaggio contro quel punteggio, senza lasciarlo allontanare troppo dal punto di partenza.
Seguiremo un solo esempio lungo tutto il post. Il prompt è «Spiega a un bambino di dieci anni perché il cielo è blu». Per adattare il reinforcement learning a questo contesto servono tre modifiche: il reward non è scritto, ma appreso; la stessa risposta si può descrivere come una scelta unica o come una sequenza di token; e l’ottimizzazione va ancorata a un modello di riferimento, perché il reward appreso è imperfetto.
1. Da un reward scritto a un reward appreso
Nel primo post il reward era qualcosa che l’ambiente restituisce: alla fine di una partita a scacchi si vince, si perde o si pareggia. Anche con il linguaggio, a volte, una regola del genere si può scrivere: se il compito è risolvere un’equazione o far passare dei test automatici, la risposta si verifica. Ma per qualità aperte come l’utilità, la chiarezza o il tono non esiste una formula che stabilisca quanto è buona una spiegazione del cielo blu per un bambino. Al suo posto si usa un reward model, : una rete neurale che riceve un prompt e una risposta completa e restituisce un numero. Il pedice indica i suoi parametri, i numeri che cambiano durante l’addestramento.
Il reward model viene addestrato su confronti, con una loss, cioè una funzione che misura l’errore e che l’addestramento cerca di ridurre. Il modello genera due spiegazioni del cielo blu, A e B; un annotatore preferisce A; l’addestramento spinge il punteggio di A sopra quello di B. Ripetuto su molti prompt, il modello impara ad approssimare le preferenze di quel gruppo di annotatori, sui prompt raccolti e secondo le istruzioni che hanno ricevuto: non le preferenze dell’umanità in generale. La formula esatta di questa loss la vediamo nel post successivo. Qui basta una sua conseguenza: il punteggio non è un voto calibrato su una scala assoluta. Contano le differenze fra i punteggi di risposte allo stesso prompt: il loro ordine è essenziale, e anche la loro ampiezza ha un ruolo.
Poi il reward model viene usato. Il modello di linguaggio genera una risposta, il reward model la valuta, un ottimizzatore rende più probabili le risposte premiate, e il ciclo si ripete. È qui che nasce un rischio. A differenza di una regola scritta, è un’approssimazione e commette errori, in particolare su risposte lontane da quelle viste durante l’addestramento. L’ottimizzatore non distingue fra «risposta davvero buona» e «risposta che il giudice valuta bene per errore»: se l’ottimizzazione viene spinta abbastanza da portare il modello fuori dalla zona coperta dai dati, può trovare e sfruttare quegli errori. Lo sfruttamento di una falla del reward si chiama reward hacking; il regime in cui il punteggio continua a salire mentre la qualità reale smette di migliorare si chiama over-optimization.
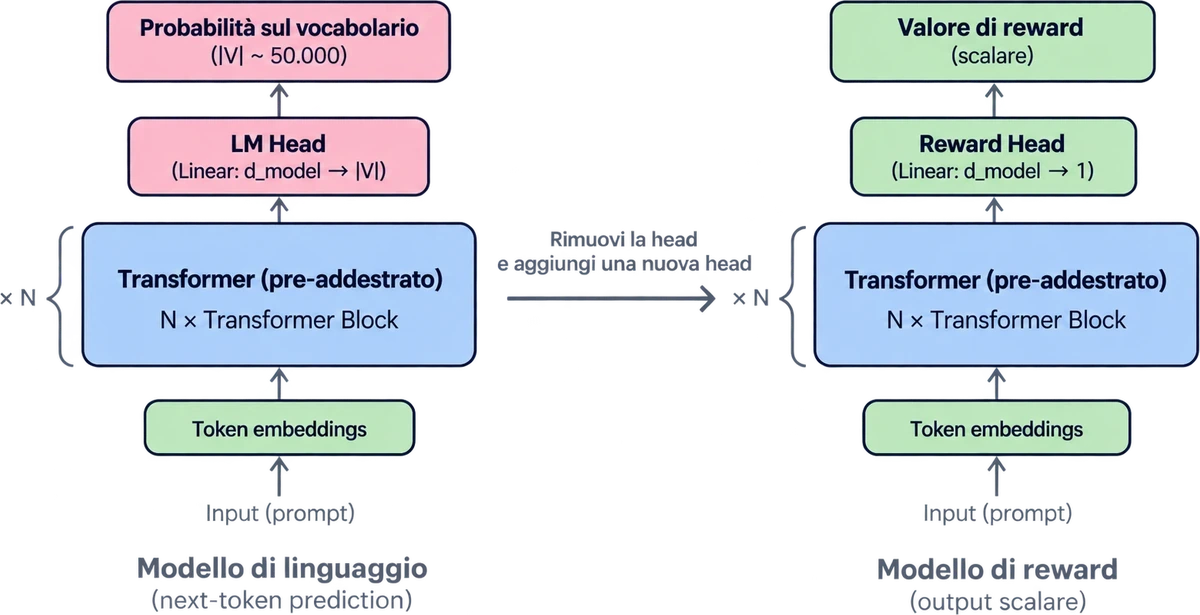
Come si costruisce in pratica il reward model? Nelle architetture descritte dai paper di riferimento si parte da un Transformer, la rete che elabora il testo, inizializzato da un modello di linguaggio. Si sostituisce la testa di uscita, che in un modello di linguaggio produce una probabilità per ogni token del vocabolario, con una che produce un singolo numero, di solito ricavato dall’ultimo token della risposta. Durante il suo addestramento può essere aggiornato l’intero modello, non soltanto la testa. Il modello di linguaggio da addestrare e il reward model sono due reti separate: possono partire dallo stesso punto, ma non condividono i pesi. Durante una fase di ottimizzazione il reward model viene di solito tenuto fisso, congelato; nelle pipeline iterative lo si può riaddestrare fra un ciclo e il successivo.
Il passaggio da regola scritta a modello appreso ha un’implicazione che va oltre la tecnica: trasforma il reward da pezzo dell’ambiente a scelta di progetto. Chi annota, quali prompt vengono mostrati, quali criteri vengono dati, come si compongono i disaccordi fra annotatori e quali comportamenti non vengono misurati affatto: sono queste scelte a decidere che cosa il modello considererà desiderabile. Ogni distorsione in queste scelte si riflette nel comportamento finale.
2. Una risposta, due livelli di descrizione
La seconda modifica riguarda la struttura del problema, e qui conviene distinguere subito due livelli.
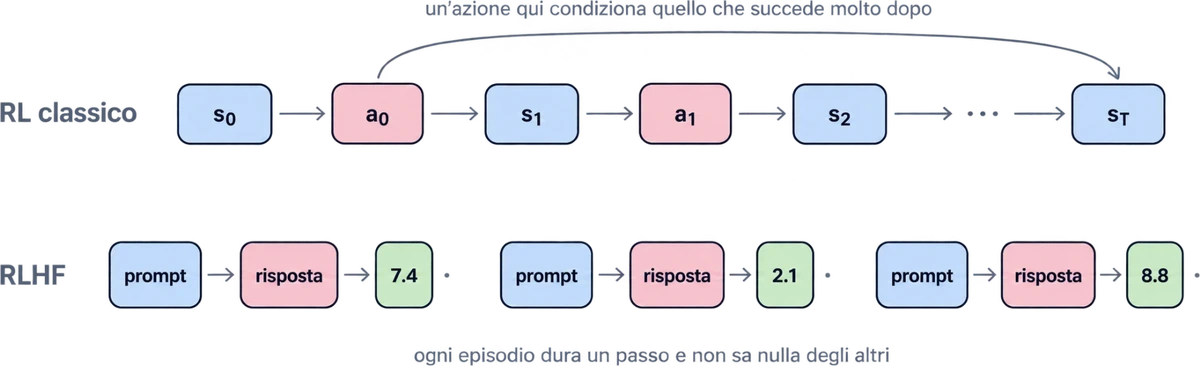
La vista a risposta. Lo stato di partenza è il prompt, l’azione è la risposta intera, e il reward arriva subito dopo. Qui l’episodio finisce: la risposta sul cielo blu non influenza il prompt successivo, che viene estratto indipendentemente dallo stesso insieme. Ogni episodio è condizionato dal proprio prompt e non sa nulla degli altri. Nei compiti a decisione sequenziale del primo post, invece, ogni azione produce un nuovo stato, e una scelta può condizionare ciò che accade molti passi dopo; a questo livello quel legame manca. È il bandit contestuale che il primo post aveva anticipato come caso limite. Bandit perché si compie una scelta e si osserva il reward, senza pianificare una catena di stati successivi; contestuale perché, prima della scelta, si riceve un contesto: il prompt.
La vista a token. La risposta, però, non nasce tutta insieme: il modello la scrive un token alla volta, e un token è un’unità del vocabolario, che può essere una parola, un pezzo di parola o un segno di punteggiatura. A questo livello il problema è un MDP, Markov Decision Process: la formalizzazione di stati, azioni, transizioni e reward nel tempo, la stessa struttura che nel primo post abbiamo usato per la griglia. Con la stessa notazione del primo post, lo stato è il prompt più il prefisso già generato, l’azione è il token successivo, che diventa il token della risposta, e la transizione è deterministica: il token scelto si aggiunge al prefisso e forma lo stato seguente. Il reward del giudice arriva una volta sola, alla fine, sulla risposta completa.
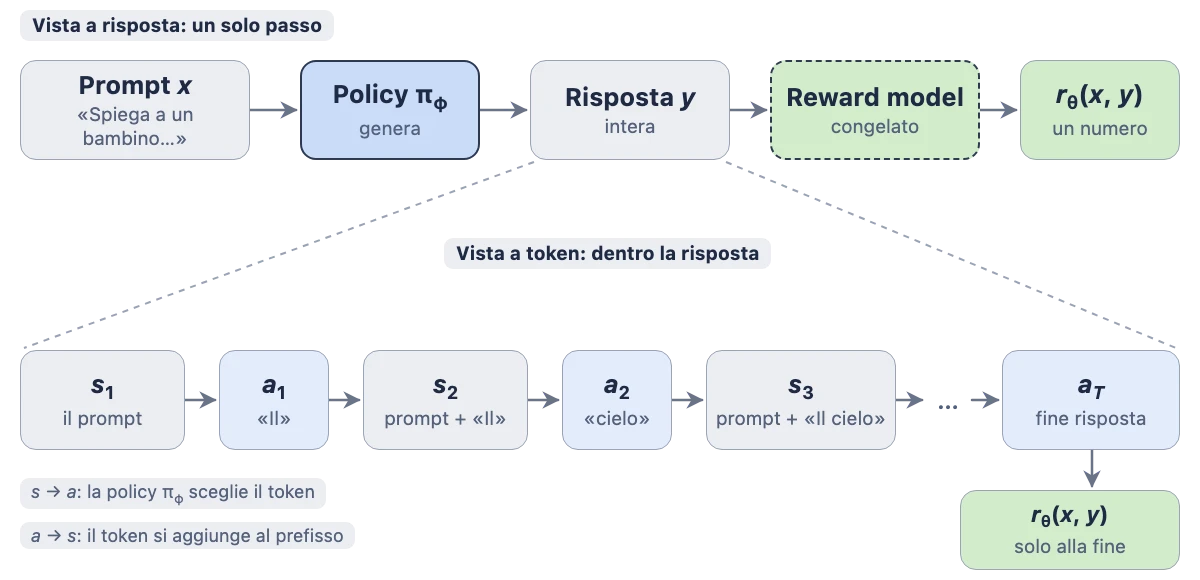
Le due viste non sono in competizione: descrivono lo stesso oggetto a due granularità diverse. Il ponte è una proprietà dei modelli autoregressivi, quelli che generano un token alla volta. Chiamiamo policy, come nel primo post, la regola probabilistica con cui il modello sceglie; qui la indichiamo con , dove sono i parametri del modello di linguaggio, distinti dai del reward model. La probabilità che la policy assegna alla risposta intera è il prodotto delle probabilità assegnate, passo dopo passo, ai suoi token:
Qui è il numero di token della risposta, numerati da 1 a ; nel primo post le azioni partivano invece da . La seconda forma è quella che conta in pratica: rendere più probabile una risposta significa rendere più probabili le scelte che la compongono. Per questo un punteggio dato alla risposta intera può guidare l’aggiornamento dei singoli token.
C’è una sottigliezza nel passare da un livello all’altro, e riguarda il fattore di sconto del primo post: un numero fra 0 e 1 che pesa con le ricompense ricevute al passo , riducendo il peso di quelle più lontane nel tempo. Chiamiamo ritorno visto dal token la somma scontata dei reward da lì alla fine della risposta. Se l’unico reward non nullo è quello finale, , ricevuto con l’ultimo token , quel ritorno vale:
Con i primi token della risposta, i più lontani dal reward, ricevono un segnale più attenuato degli ultimi. Ma il voto è stato dato alla risposta intera, e non c’è motivo per cui l’inizio della spiegazione del cielo blu debba contare meno della fine. Per questo in RLHF si usa di solito , come il primo post già permetteva su un orizzonte finito: il reward finale arriva a ogni token senza attenuazione. La risposta non diventa per questo un’unica azione: le azioni restano token, cambia solo il fatto che nessuno di essi viene scontato.
Nella vista a risposta l’obiettivo si scrive in modo compatto. Sia la distribuzione dei prompt, cioè da quale insieme vengono estratti e con quali frequenze. Si campiona un prompt da , la policy genera una risposta , il reward model assegna , e si vuole che in media questo punteggio sia il più alto possibile:
indica una media sui prompt e sulle risposte campionate. La presenza di non è un dettaglio: il modello viene ottimizzato soltanto sui prompt di quella distribuzione, e ciò che non vi compare non riceve alcun segnale.
RLHF eredita dal reinforcement learning l’impianto concettuale — la formulazione del problema e la famiglia degli ottimizzatori — ma le difficoltà principali si spostano. Mancano le dinamiche esterne ignote e la pianificazione su una lunga catena di stati dell’ambiente. Restano, e diventano centrali, la qualità del reward model, l’esplorazione in uno spazio di risposte enorme, l’attribuzione del merito ai singoli token e il rischio che la policy si allontani dalla zona in cui il giudice è affidabile.
3. La policy di riferimento e la penalità KL
L’ultimo rischio porta alla terza modifica. Il reward model è un’approssimazione, e ottimizzarlo troppo può portare la policy fuori dalla regione in cui è affidabile. Serve quindi un costo per l’allontanamento dal punto di partenza. Per capire rispetto a che cosa, conviene dare un nome stabile a ogni modello:
- il modello base è quello uscito dal pretraining;
- il modello SFT è il modello base dopo il fine-tuning supervisionato, cioè un addestramento ulteriore su risposte di esempio scritte da persone;
- la policy è il modello che l’RL sta addestrando, inizializzato dal modello SFT;
- la policy di riferimento è una copia congelata del punto di partenza, nella pipeline classica il modello SFT.
Il costo si misura con la divergenza di Kullback-Leibler (KL), che dice quanto la distribuzione della policy si sia allontanata da quella del riferimento. Dato uno stato , entrambi i modelli assegnano una probabilità a ogni token del vocabolario, e la KL fra le due distribuzioni è:
Vale zero se le due distribuzioni coincidono e cresce man mano che si separano. Non è però una distanza in senso stretto: non è simmetrica, e scambiare i due argomenti dà un numero diverso. Chiamarla «distanza» resta una comoda metafora.
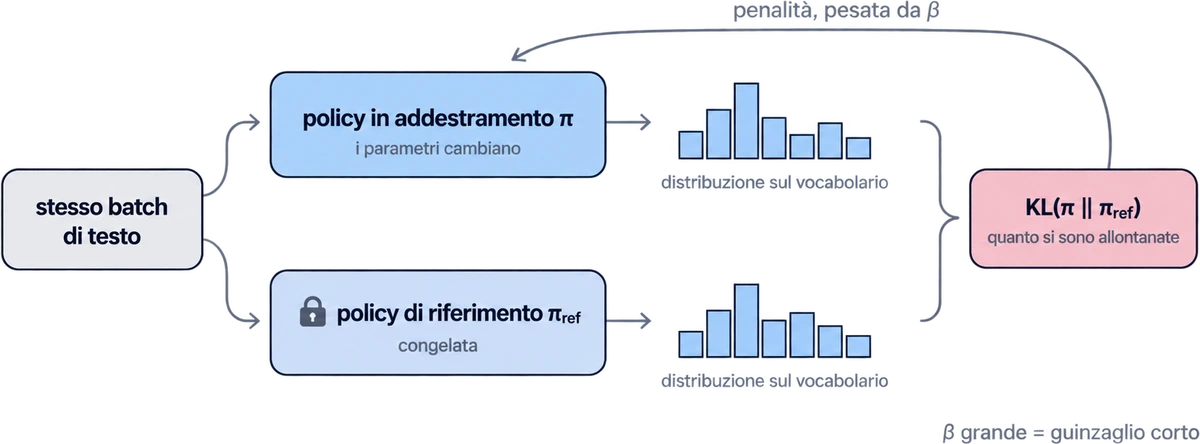
In pratica, nelle implementazioni di RLHF di solito non si calcola la somma su tutto il vocabolario. Si prendono le risposte che la policy ha appena generato, le si fanno leggere a entrambi i modelli, e per ogni token effettivamente scelto si calcola il logaritmo del rapporto fra le due probabilità. Il costo entra così direttamente nell’obiettivo:
Grazie alla (1), il logaritmo del rapporto fra le probabilità dell’intera risposta si scompone nella somma dei log-rapporti dei singoli token:
Per questo si parla di una penalità KL per token. Sul singolo token il log-rapporto può anche essere negativo; è la sua media sulle risposte della policy a corrispondere alla divergenza. Il coefficiente è un iperparametro, cioè un numero scelto dal progettista e non appreso: con grande allontanarsi costa di più e il guinzaglio è corto, con piccolo il reward può spostare di più la policy. Si sente parlare anche di budget KL: è un modo informale di indicare quanto allontanamento medio si è disposti ad accettare, non un limite rigido, perché qui la KL è un costo e non un vincolo.
C’è un limite che conviene dire subito. La penalità misura l’allontanamento sui prompt e sui prefissi che l’addestramento incontra davvero; non garantisce che il modello resti invariato su compiti che l’RL non tocca mai. È esattamente il problema dell’alignment tax che vedremo in InstructGPT.
Come il reward aggiorna la policy
Resta una domanda naturale. Il reward model restituisce un solo numero, e i token sono scelte discrete: come arriva quel numero ai pesi del modello? La risposta è la famiglia dei metodi policy gradient. Il reward non deve essere derivabile: viene usato come peso del gradiente della log-probabilità della risposta campionata (il gradiente è la direzione in cui spostare i parametri per aumentare quella log-probabilità).
Qui è il reward complessivo della risposta, cioè il punteggio meno la penalità KL della (5), e è una baseline, una stima di quanto ci si aspettava. La differenza si chiama advantage: se la spiegazione del cielo blu è andata meglio del previsto, l’aggiornamento aumenta la sua log-probabilità, cioè, per la (1), quella dei token che la compongono; se è andata peggio, la riduce. Nessun gradiente attraversa il reward model: il giudice dà solo il peso.
L’algoritmo canonico delle prime pipeline RLHF su larga scala, InstructGPT compresa, è PPO, Proximal Policy Optimization. In una frase: PPO genera un gruppo di risposte con la policy, stima token per token quanto ogni scelta sia andata meglio o peggio del previsto e fa più passi di aggiornamento sugli stessi dati, riducendo l’incentivo a cambiare troppo la policy in un solo aggiornamento. Per farlo confronta la policy con , la fotografia della policy che ha generato quelle risposte. Attenzione a non confonderla con : cambia a ogni gruppo di dati e frena lo spostamento su quel gruppo, resta ferma per tutto l’addestramento e trattiene l’intero percorso. E il freno di PPO non è un limite rigido: taglia il premio per i cambiamenti troppo grandi, ma non impedisce matematicamente che avvengano. Il critico, la rete che fornisce quella stima, l’advantage per token e il clipping li vediamo in dettaglio nel post su InstructGPT.
Le altre strade
PPO non è l’unico modo di usare le preferenze. Prima di vedere le alternative, conviene separare ciò che prepara la policy da ciò che la ottimizza.
Il fine-tuning supervisionato (SFT) prepara il punto di partenza. Il modello viene addestrato su esempi di domanda e risposta scritti da persone. Le dimostrazioni codificano molto più del formato: contenuti, stile, livello di dettaglio, rifiuti, procedure. Anche un modello base può rispondere a una domanda, se il testo lo invita a farlo; l’SFT rende quel comportamento stabile e accessibile. La differenza con i dati di preferenza è che l’SFT mostra un bersaglio da imitare, non un confronto fra alternative. È la pratica canonica prima dell’RL, e nella pipeline classica il modello SFT diventa , ma non è una necessità matematica.
Dopo la raccolta delle preferenze la strada si biforca. Da un lato si addestra un reward model esplicito, e lo si usa in tre modi:
- best-of-N: al momento dell’uso si generano risposte candidate, per esempio otto spiegazioni del cielo blu, e si restituisce quella con il punteggio più alto;
- rejection-sampling fine-tuning: si conservano le risposte vincitrici di molti prompt e su di esse si fa un normale SFT. Il nome non è usato in modo uniforme in letteratura; qui indica questa procedura;
- reinforcement learning, per esempio con PPO: il reward pesa direttamente l’aggiornamento delle log-probabilità delle risposte che la policy genera durante l’addestramento.
Dall’altro lato c’è l’ottimizzazione diretta delle preferenze, una famiglia di metodi il cui esponente più noto è DPO, Direct Preference Optimization. DPO non addestra un reward model separato: dalle coppie formate da una risposta preferita e una scartata ricava una loss che aggiorna direttamente la policy, confrontando le probabilità delle due risposte rispetto a quelle di . Non è un semplice SFT sulla risposta preferita, perché guarda sempre la coppia. Un reward, in DPO, c’è ancora, ma è implicito nel rapporto fra policy e riferimento. Nella versione originale lavora offline, cioè solo sulle coppie raccolte prima dell’addestramento; varianti online e iterative rigenerano le coppie periodicamente.
| Metodo | Che cosa usa | Come cambia il modello |
|---|---|---|
| Best-of-N | Reward model, risposte per prompt | Non lo cambia: sceglie la risposta migliore al momento dell’uso |
| Rejection-sampling fine-tuning | Reward model, risposte generate e selezionate | SFT sulle risposte vincitrici |
| PPO | Reward model, risposte generate durante l’addestramento | Il reward pesa l’aggiornamento delle log-probabilità |
| DPO | Coppie preferita/scartata, , nessun reward model | Loss sulle coppie, di solito offline |
Questi metodi non sono tappe obbligate di una stessa sequenza. PPO e DPO sono spesso strade alternative; il best-of-N si può usare da solo o per generare dati per un SFT successivo. E quando si legge che un modello «è stato addestrato con RLHF», spesso si intende il senso ampio: SFT più uno o più di questi passaggi.
Perché usare il reinforcement learning
Se SFT e best-of-N sono più semplici, perché complicarsi la vita con l’RL? Il confronto operativo è questo. L’SFT imita una risposta bersaglio fornita in anticipo. Il best-of-N sceglie la migliore fra un numero finito di risposte. L’RL invece genera risposte con la policy corrente e usa un reward sulla sequenza intera per modificarne direttamente le probabilità. La differenza sta in due cose: impara dagli output che la sua distribuzione produce mentre cambia, e usa il reward come un peso continuo sull’aggiornamento, non come una selezione secca fra vincitori e vinti. Può così ottimizzare obiettivi per cui non esiste una singola risposta corretta da copiare.
In cambio chiede molto. La generazione di risposte durante l’addestramento è costosa; servono un critico, cioè una rete che stima il ritorno atteso, o una baseline; l’ottimizzazione è più instabile; c’è il rischio di over-optimization; e il modello può peggiorare su ciò che l’addestramento non misura. Perché, in certi regimi, l’RL produca modelli che generalizzano meglio di un fine-tuning supervisionato con dati simili è ancora una domanda aperta della ricerca.
Un esempio spesso citato riguarda la specializzazione. In alcuni esperimenti recenti, addestrando con RL su una fascia ristretta di prompt, per esempio problemi di matematica con un reward calcolato da una verifica automatica, il modello migliora su quel dominio conservando le altre capacità meglio di un fine-tuning supervisionato sugli stessi problemi, a parità di prestazioni sul nuovo compito (Shenfeld e colleghi). Quando il reward viene da una verifica automatica e non da preferenze umane, però, si parla più precisamente di RL con reward verificabili. E non è una garanzia generale: InstructGPT, come vedremo, osserva regressioni su diversi benchmark, cioè i test standard con cui si misurano le capacità dei modelli, e introduce una correzione apposta.
Abbiamo ora i quattro pezzi che servono: una policy che parte da un modello già capace, un giudice appreso dalle preferenze, un aggiornamento guidato dal reward e una policy di riferimento che limita lo spostamento. Nel prossimo post li vedremo insieme in InstructGPT, una delle prime dimostrazioni su larga scala dell’RLHF per un assistente generalista e il lavoro che ha reso canonica la pipeline SFT, reward model e PPO. Non è stato il primo uso del feedback umano sui modelli di linguaggio: prima erano arrivati il fine-tuning da preferenze umane di Ziegler e colleghi, il riassunto automatico addestrato con feedback umano di Stiennon e colleghi e WebGPT.