RLHF — Come è fatto InstructGPT
Un modello di linguaggio appena pre-addestrato ha imparato a continuare un testo, non a fare quello che gli viene chiesto. Il reinforcement learning from human feedback (RLHF) serve a colmare questa distanza: usa giudizi umani per costruire un segnale con cui modificare il comportamento del modello. Oggi vediamo uno dei casi più influenti in cui è stato applicato su larga scala: InstructGPT, il lavoro pubblicato da OpenAI nel 2022 che ha contribuito a definire il modo in cui vengono addestrati molti degli assistenti moderni. Il nome indica sia la procedura sia la famiglia di modelli, di diverse dimensioni, addestrati con essa.
L'obiettivo del paper è ottenere un modello allineato. La parola ha qui un significato preciso e limitato: un modello che segue le intenzioni di chi scrive e produce risposte che un gruppo specifico di annotatori giudica migliori, non un modello conforme a una nozione universale di valori umani. Ci torneremo in chiusura. Per seguire il post non serve conoscere il paper né gli algoritmi di reinforcement learning che usa: introdurremo ogni componente nel momento in cui entra nella pipeline. Chi vuole approfondire le basi le trova nei due post precedenti della serie, sul reinforcement learning e su come lo si adatta ai modelli di linguaggio.
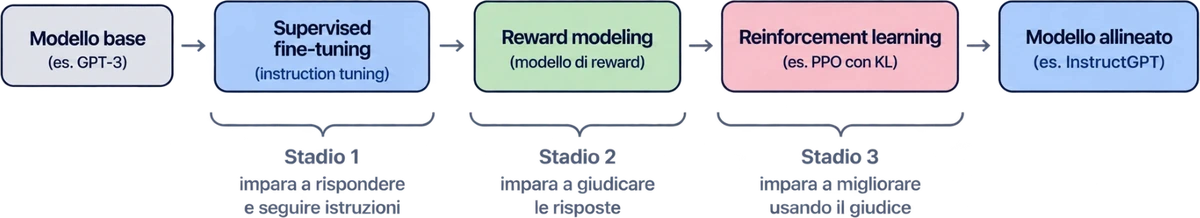
Il metodo si articola in tre stadi, ognuno dei quali risolve un problema diverso. Prima si mostra al modello come dovrebbe rispondere; poi si costruisce un giudice capace di confrontare risposte diverse; infine si usa quel giudice per rendere più probabili le risposte migliori. Gli stadi sono presentati in ordine logico, ma nella pratica non formano una catena rigida: il giudice del secondo stadio serve anche a scegliere il risultato del primo, e il secondo e il terzo possono essere ripetuti più volte, raccogliendo nuovi confronti sulle risposte del modello più recente.
Stadio 1 — Supervised fine-tuning
Il pretraining è il primo, grande addestramento di un modello di linguaggio: il modello legge enormi quantità di testo e impara a prevedere il token successivo, cioè la prossima unità di testo, che può essere una parola, un pezzo di parola o un segno di punteggiatura. Un modello appena uscito dal pretraining non è stato addestrato specificamente a rispondere alle domande: è stato addestrato a continuare il testo. Se gli si dà come prompt, cioè come testo di ingresso, «Qual è la capitale della Francia?», potrebbe rispondere elencando altre domande simili anziché dire «Parigi». Ha imparato a prevedere il testo, non a seguire le intenzioni dell'utente. Il primo stadio serve proprio a modificare questo comportamento.
Come? Semplice: gli annotatori scrivono una serie di dimostrazioni — dato un prompt, ecco come dovrebbe rispondere un buon assistente — e il modello viene addestrato ancora, questa volta su quegli esempi. Addestrare ulteriormente un modello già pre-addestrato, su dati e obiettivi più specifici, si chiama fine-tuning. Nel paper questo stadio si chiama supervised fine-tuning (SFT) ed è una forma di instruction tuning: il suo obiettivo è insegnare al modello non solo a generare testo, ma anche a seguire istruzioni.
Il risultato più curioso di questo stadio richiede qualche parola del mestiere. Un'epoca è un passaggio completo sui dati di addestramento. La loss è il numero che misura l'errore rispetto all'obiettivo di addestramento: qui, quanto è bassa la probabilità che il modello assegna ai token delle dimostrazioni. Una parte dei dati viene tenuta da parte come insieme di validazione (validation set): non serve ad aggiornare i pesi, cioè i numeri che l'addestramento regola, ma a controllare come il modello se la cava su esempi che non ha visto. Quando la loss di validazione comincia a salire, di solito si parla di overfitting: il modello si sta adattando troppo agli esempi di addestramento e generalizza peggio. Durante l'addestramento, infine, si salvano periodicamente copie dei pesi, i checkpoint, fra cui alla fine se ne sceglie una.
Ecco il risultato controintuitivo. Gli autori addestrano i modelli SFT per 16 epoche e osservano che la loss di validazione comincia a peggiorare già dopo la prima. Di solito è un segnale di overfitting e suggerirebbe di fermare l'addestramento lì, con quello che si chiama early stopping. Eppure, proseguire migliora sia le valutazioni umane sia il punteggio di un giudice automatico che costruiremo nello Stadio 2. La loss dice che il modello peggiora; le persone e il giudice dicono il contrario.
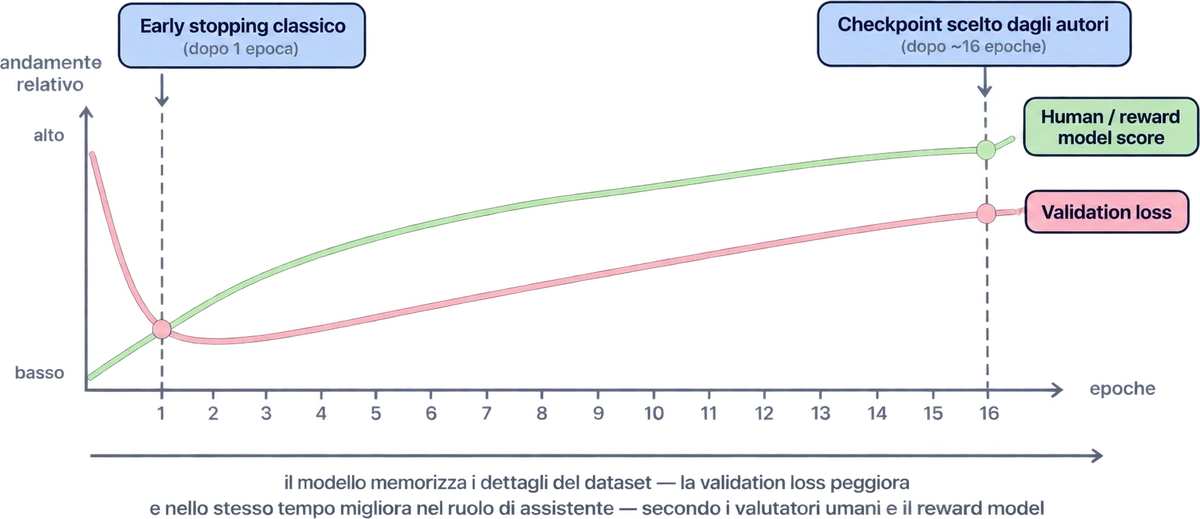
Una possibile spiegazione è che la loss usata durante l'addestramento misura quanta probabilità il modello assegna, token dopo token, alla specifica risposta scritta dall'annotatore. Ma per uno stesso prompt possono esistere molte risposte valide, anche formulate in modi molto diversi. Il giudice e i valutatori umani riescono a riconoscere questa qualità più generale; la loss, invece, rimane legata a un'unica risposta di riferimento.
Le dimostrazioni insegnano al modello una prima forma di comportamento, ma non permettono ancora di confrontare due risposte nuove e dire quale sia la migliore. Per farlo serve un giudice.
Stadio 2 — Reward Modeling
Il secondo stadio costruisce quel giudice: il reward model. Riceve in ingresso un prompt insieme a una risposta completa e restituisce un solo numero, un punteggio. Quel numero non va letto come un voto assoluto: ha un significato relativo, e ciò che conta è che una risposta migliore riceva un punteggio più alto di una peggiore. È la stessa proprietà che abbiamo incontrato nel post precedente.
Da dove arrivano le etichette per addestrarlo? Gli annotatori assegnavano anche valutazioni su una scala da 1 a 7, ma quei voti servivano ad altro, per esempio a valutare i modelli. Il segnale usato per addestrare il reward model proveniva invece dagli ordinamenti fra più risposte allo stesso prompt.
Per raccogliere questi dati più rapidamente, agli annotatori venivano mostrate più risposte allo stesso prompt, da ordinare dalla migliore alla peggiore. Chiamiamo il numero di risposte mostrate per ciascun prompt; nel paper varia da 4 a 9. È molto più efficiente che chiedere di giudicare separatamente ogni coppia: da un solo ordinamento si ricavano tutte le coppie possibili, cioè fino a confronti, che con nove risposte diventano 36, escludendo gli eventuali pareggi.
Come si insegna al giudice un confronto? Prendiamo una coppia: un prompt , la risposta preferita (winner) e quella meno preferita (loser). Il reward model, con parametri , assegna a ciascuna un punteggio, e . La sigmoide trasforma la differenza fra i due punteggi in un numero fra 0 e 1, che si può leggere come la probabilità, secondo il giudice, che la prima risposta sia davvero la migliore. La loss di una coppia è:
A parole: la loss diminuisce quando il giudice assegna alla risposta preferita un punteggio più alto dell'altra, e diminuisce tanto più quanto più è grande la differenza nella direzione giusta. Contano solo le differenze, mai i valori assoluti: per questo la scala del reward model è arbitraria. Prima del terzo stadio gli autori spostano infatti tutti i punteggi di una costante, in modo che le dimostrazioni degli annotatori abbiano in media punteggio zero.
C'è però un problema: i confronti ottenuti dallo stesso ordinamento sono fortemente correlati. Prendiamo quattro risposte ordinate A > B > C > D: ne escono sei coppie, A > B, A > C, A > D, B > C, B > D e C > D, e la risposta A compare in tre di esse. In generale ogni risposta compare in confronti. Se le coppie vengono mescolate e trattate come esempi indipendenti, ciascuna produce un aggiornamento separato dei pesi, e la stessa risposta viene elaborata fino a volte. Si esegue formalmente una sola epoca, ma al suo interno la stessa risposta viene riutilizzata più volte, accelerando l'overfitting.
Gli autori risolvono il problema così. I pesi di un modello non vengono aggiornati dopo ogni singolo esempio, ma dopo averne elaborato un gruppo, il batch. Tutti i confronti derivati dallo stesso prompt diventano un unico elemento del batch: il reward model calcola una sola volta il punteggio di ciascuna delle risposte e costruisce la loss combinando i termini della (1) su tutte le coppie. I confronti rimangono tutti presenti, ma contribuiscono insieme allo stesso passo di aggiornamento. Il risultato è un addestramento più efficiente e un netto miglioramento sia dell'accuratezza, cioè la quota di coppie ordinate correttamente, sia della loss sull'insieme di validazione.
Resta da vedere com'è fatto il giudice. Non si parte da zero: si riutilizza il corpo di un modello linguistico già addestrato, il Transformer, cioè la parte della rete che trasforma il testo in rappresentazioni interne e che possiede già una buona rappresentazione del linguaggio. In un modello di linguaggio, a quel corpo segue una testa (head): lo strato finale che converte le rappresentazioni in una probabilità per ogni token del vocabolario. Nel reward model quella testa viene rimossa e sostituita con una che restituisce un singolo numero, uno scalare. Anziché predire il token successivo, il modello impara così a valutare la risposta.
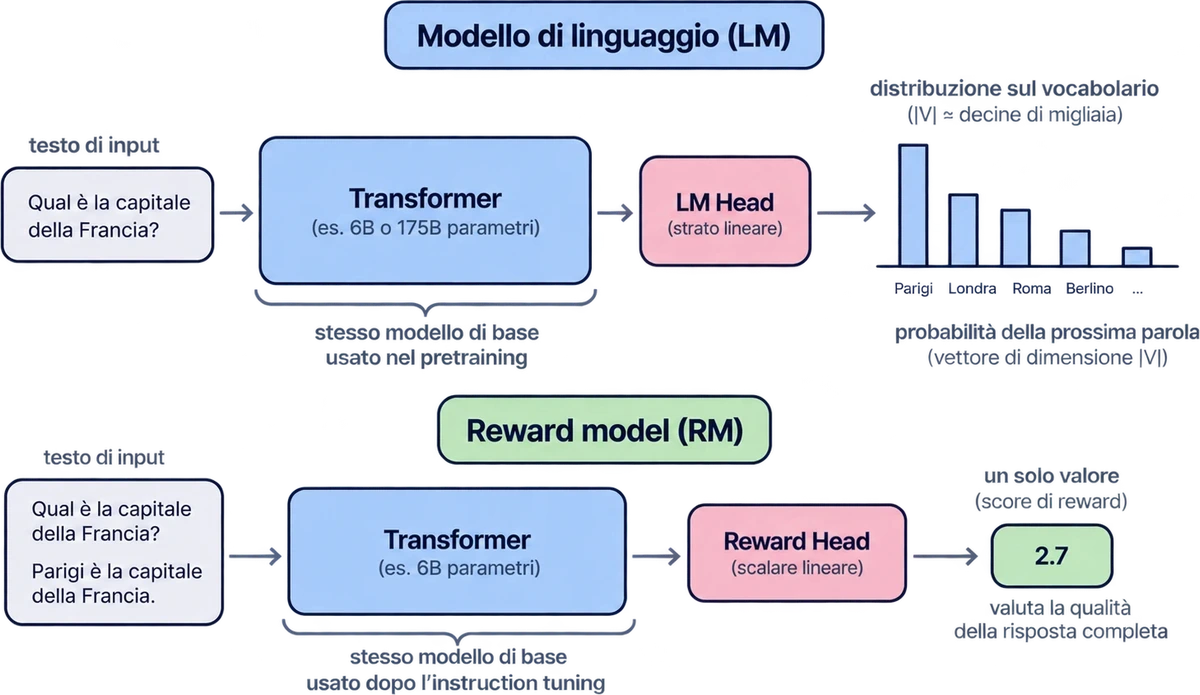
Nella formulazione generale della procedura, il reward model può essere inizializzato dai pesi del modello SFT. Nell'esperimento finale di InstructGPT, però, gli autori partono da un GPT-3 da 6 miliardi di parametri già fine-tuned su diversi dataset pubblici di elaborazione del linguaggio naturale (NLP), riferendo risultati simili anche nelle prove condotte a partire da GPT-3 o dall'SFT.
La scelta di un reward model da 6 miliardi di parametri, anziché da 175, non dipende soltanto dai costi. Il modello più grande poteva ottenere una loss di validazione più bassa, ma il suo addestramento risultava meno stabile. Nelle prove preliminari, invece, il modello da 6 miliardi restava stabile con un ampio intervallo di learning rate, cioè di ampiezze del passo con cui si aggiornano i pesi, e veniva usato come giudice per modelli di tutte le dimensioni, compreso quello da 175 miliardi. È un risultato controintuitivo: in questo esperimento, un giudice circa trenta volte più piccolo era sufficiente per addestrare un modello molto più grande. Vedremo nello Stadio 3 che la stabilità contava anche per un altro motivo.
Una volta addestrato il reward model, gli autori lo usano anche per valutare retrospettivamente i checkpoint prodotti durante l'SFT e scelgono quello che ottiene il punteggio più alto sull'insieme di validazione. È il ritorno all'indietro di cui parlavamo all'inizio: il giudice costruito nel secondo stadio fa anche da criterio di selezione per il primo.
Ora possiamo trasformare ogni coppia prompt-risposta in un punteggio. Resta il problema decisivo: come si usa quel numero per cambiare i pesi del modello?
Stadio 3 — Reinforcement learning
È il compito del terzo stadio, che usa un algoritmo di reinforcement learning chiamato PPO, Proximal Policy Optimization. In una frase: PPO fa generare al modello delle risposte, le valuta e aumenta la probabilità delle scelte andate meglio del previsto, riducendo quella delle scelte andate peggio, senza permettere a un singolo aggiornamento di spostare troppo il modello. Nel linguaggio del reinforcement learning, chi sceglie si chiama policy: qui è lo stesso modello di linguaggio, visto come la distribuzione di probabilità con cui sceglie il token successivo.
Per applicare questo linguaggio alla generazione di testo basta fare qualche corrispondenza:
- lo stato è il prompt più i token già generati;
- l'azione è il token successivo;
- la policy è il modello che assegna una probabilità a ciascun token possibile;
- il reward finale è il punteggio che il reward model assegna alla risposta completa, a cui si aggiunge, token per token, una piccola penalità di cui parliamo fra poco;
- un episodio è la generazione di una risposta completa.
Vista dall'esterno, l'interazione è più semplice di quanto la parola «reinforcement learning» possa suggerire: si estrae un prompt fra quelli inviati dagli utenti all'API di OpenAI, la policy genera una risposta, il reward model le assegna un punteggio e l'episodio termina. La risposta appena prodotta non determina quale sarà il prompt successivo. È in questo senso che il paper parla di bandit environment: un ambiente in cui a ogni scelta segue un premio, senza che la scelta cambi la situazione successiva.
Questo non significa, però, che la generazione avvenga con una sola decisione. La risposta viene costruita token dopo token e ciascun token entra nel contesto da cui verrà scelto il successivo. Il problema è un bandit al livello esterno — un prompt, una risposta, un premio — ma una sequenza di decisioni dipendenti tra loro al livello interno. Le due viste sono messe a confronto nel post precedente.
Durante questo stadio entrano in gioco più componenti, ed è utile distinguerli con cura:
- la policy , con parametri , è il modello che viene aggiornato;
- il modello di riferimento è una copia congelata del modello supervisionato da cui parte PPO, e non cambia per tutto lo stadio;
- è una fotografia della policy, scattata quando ha generato le risposte che si stanno usando per l'aggiornamento corrente;
- il reward model, congelato, assegna il premio finale;
- il critico, addestrato insieme alla policy, stima quanto ci si può aspettare da una risposta ancora incompleta.
Una precisazione sul punto di partenza. Il modello supervisionato da cui parte PPO non è il modello SFT a 16 epoche dello Stadio 1: per inizializzare le policy gli autori usano un addestramento supervisionato distinto, di due epoche sulle dimostrazioni, con un 10% di dati di pretraining mescolati, perché trovano che questo mix aiuti l'addestramento con PPO.
Il modello di riferimento serve a calcolare la penalità di divergenza di Kullback-Leibler (KL), che misura quanto la distribuzione della policy si sia allontanata da quella del riferimento. La penalità entra direttamente nel reward, token per token. Se la risposta è lunga token, il reward del token , cioè dell'azione scelta nello stato , è:
Ogni token paga il logaritmo del rapporto fra la probabilità che la policy e il riferimento assegnano al token scelto: la penalità cresce quando la policy rende quel token più probabile di quanto farebbe il riferimento. Solo l'ultimo token riceve, in più, il punteggio del reward model sulla risposta completa. Sommati lungo la risposta, questi log-rapporti danno uno stimatore, cioè una stima calcolata sulle risposte campionate, dello scostamento complessivo dal comportamento iniziale: sul singolo token il valore può anche essere negativo, ma in media sulle risposte della policy corrisponde alla divergenza. Il coefficiente è un iperparametro, cioè un numero scelto prima dell'addestramento, che stabilisce quanto penalizzare questa distanza. In pratica i log-rapporti si calcolano con la policy che ha generato le risposte e restano fissi durante l'aggiornamento: fanno parte del reward, non dell'obiettivo da derivare.
La penalità KL è uno dei principali meccanismi di stabilizzazione. Il reward model non rappresenta direttamente le preferenze umane: ne è un'approssimazione, imparata da un numero limitato di confronti. Se la policy viene spinta troppo lontano dalla distribuzione sulla quale il giudice è stato addestrato, può trovarne e sfruttarne i punti ciechi, producendo risposte che ricevono un punteggio elevato ma che una persona giudicherebbe peggiori. È il fenomeno della reward over-optimization: stabilisce quanto corto tenere il guinzaglio.
PPO utilizza inoltre una rete accessoria, chiamata funzione di valore (value function) o critico: è la funzione di valore del primo post, qui stimata da una rete. Per capire che cosa stimi serve la nozione di ritorno : la somma dei reward della (2) dal token fino alla fine della risposta, cioè le penalità KL dei token ancora da generare più il punteggio finale del reward model. Dato lo stato , cioè il prompt e il prefisso generato fino a quel momento, il critico prova a prevedere quel ritorno: la sua stima si scrive . La differenza fra ciò che è successo e ciò che il critico si aspettava è l'advantage :
La somma è scritta senza sconto, come si fa di solito in RLHF: ne abbiamo parlato nel post precedente. L'advantage indica quanto la scelta di un token sia andata meglio o peggio del previsto; nella pratica PPO ne usa una stima più stabile, che combina le previsioni del critico su più passi, ma l'idea resta questa. Se l'advantage è positivo, PPO aumenta la probabilità di quella scelta; se è negativo, tende a ridurla. Di quanto possa spostarla in un solo passo lo decide il clipping, che vediamo fra poco.
Gli autori inizializzano il critico dal reward model. La scelta è naturale perché i due compiti sono affini, ma non identici: il reward model valuta una risposta completa, mentre il critico deve prevedere il ritorno atteso a partire da ogni prefisso. È qui che torna la questione della taglia vista nello Stadio 2: un reward model da 175 miliardi, meno stabile, sarebbe stato un punto di partenza meno adatto per il critico, oltre ad aumentare sensibilmente il costo di PPO. Quello da 6 miliardi offriva un'inizializzazione più stabile.
La penalità KL, però, non è il meccanismo che rende PPO proximal. Il secondo freno è il clipping, che confronta la policy con , la versione che ha generato le risposte del batch corrente. Per ogni token si calcola il rapporto fra le due probabilità, e con quello si costruisce l'obiettivo che PPO massimizza:
Il rapporto vale 1 se la probabilità del token non è cambiata. Moltiplicato per l'advantage, dice quanto l'aggiornamento migliora le cose: se è positivo conviene far crescere , se è negativo farlo scendere. indica una media sui token del batch. La funzione costringe dentro l'intervallo fra e , dove è l'ampiezza del clipping, e il minimo sceglie sempre la versione meno generosa delle due. Con , il valore usato in InstructGPT, l'intervallo va da 0,8 a 1,2: quando il rapporto ne esce nella direzione indicata dall'advantage, l'obiettivo smette di crescere. Non è un divieto rigido: la probabilità può cambiare anche di più, ma oltre quella soglia l'aggiornamento non ne ricava ulteriore guadagno. Il clipping agisce quindi sul singolo aggiornamento, rispetto a una policy che cambia a ogni batch, mentre la KL trattiene l'intero percorso di addestramento vicino a un riferimento fisso.
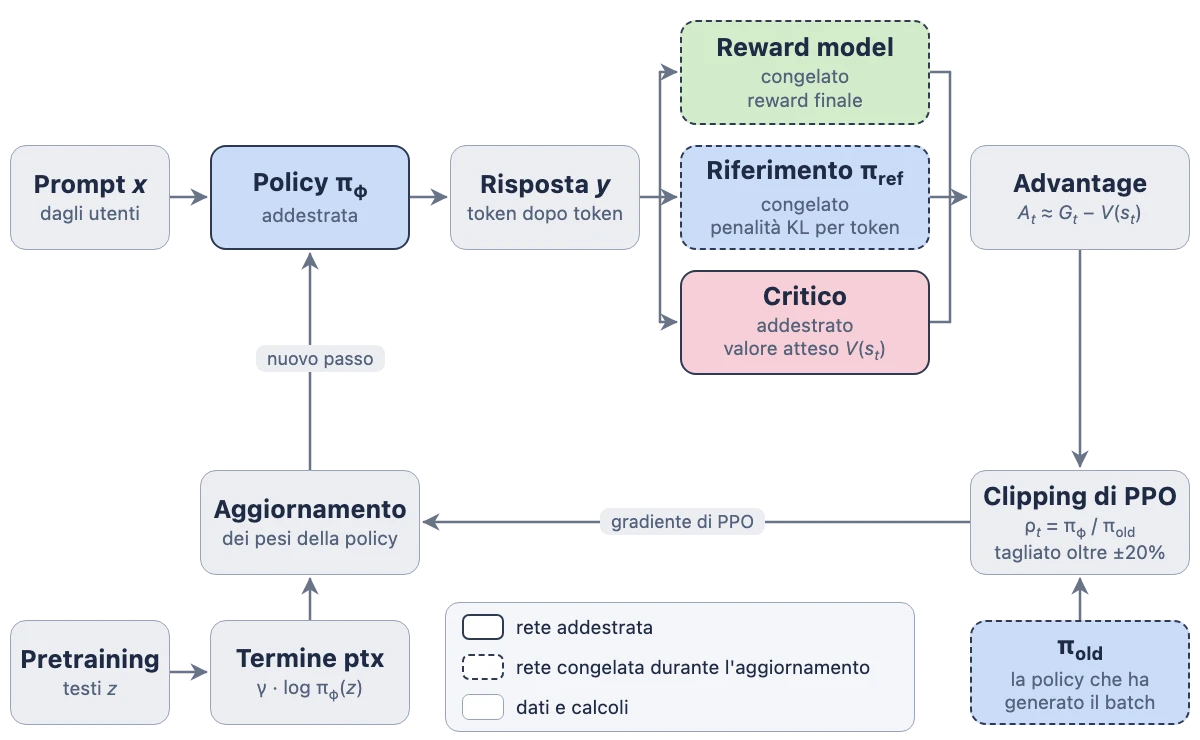
La procedura migliora le preferenze umane, ma introduce un nuovo problema: mentre ottimizza ciò che il giudice vede, il modello può perdere capacità che quei prompt non mettono alla prova.
La tassa dell'allineamento
C'è un effetto collaterale che il paper misura e non nasconde. Nei modelli PPO addestrati senza mescolare dati di pretraining, gli autori osservano regressioni rispetto a GPT-3 su diversi benchmark NLP: SQuADv2 e DROP, che misurano comprensione e ragionamento su testo; HellaSwag, dedicato al completamento e al ragionamento di senso comune; e WMT 2015, per la traduzione dal francese all'inglese. Gli autori descrivono queste regressioni come un esempio di alignment tax, la tassa dell'allineamento.
Il paper non ne dimostra una causa unica, ma le sue ablazioni — esperimenti in cui si varia un ingrediente alla volta per misurarne l'effetto — indicano che la distribuzione dei dati svolge un ruolo importante. PPO ottimizza direttamente il modello sui prompt inviati all'API; le capacità apprese durante il pretraining che sono poco rappresentate in quei prompt non ricevono lo stesso segnale di protezione e possono degradarsi. In termini intuitivi, il reward non difende direttamente le capacità che non mette mai alla prova.
La contromisura degli autori consiste nell'aggiungere all'obiettivo un termine di language modeling sui dati originali di pretraining. Detto in parole semplici: a ogni passo il modello riceve due indicazioni su come cambiare i pesi, una che viene dal reward di PPO e una che viene dal normale obiettivo di prevedere il testo. Più precisamente, per ogni minibatch, cioè per ogni piccolo gruppo di esempi, gli autori calcolano prima i gradienti di PPO e poi quelli di pretraining — un gradiente indica in che direzione spostare i pesi per migliorare un obiettivo — e li accumulano nello stesso aggiornamento.
L'obiettivo completo combina quindi tre componenti: il punteggio del reward model, la penalità KL e la log-likelihood dei dati di pretraining, cioè il logaritmo della probabilità che la policy assegna a quei testi. Prima di scriverlo, i simboli:
- è un prompt e la risposta generata dalla policy; è la distribuzione di queste coppie;
- è un testo dei dati di pretraining, estratto dalla loro distribuzione , e è la probabilità che la policy assegna a quel testo;
- , come nella (4), indica una media: qui sugli esempi estratti dalla distribuzione scritta in pedice;
- è il punteggio del reward model;
- e sono le probabilità che policy e riferimento assegnano all'intera risposta: il logaritmo del loro rapporto è la somma dei log-rapporti per token della (2);
- pesa la penalità KL e il termine di pretraining. Attenzione: qui non è il fattore di sconto del primo post, ma un altro coefficiente che il paper indica con la stessa lettera.
I tre termini esercitano tre forze differenti: il reward model spinge la policy verso le risposte preferite dagli annotatori; la penalità KL la trattiene vicino al modello supervisionato; il termine di pretraining aiuta a conservarne le capacità generali. La formula descrive che cosa viene ottimizzato, non tutta la meccanica: il clipping di PPO e l'addestramento del critico stabiliscono come eseguire ciascun aggiornamento.
Ponendo uguale a zero si torna al PPO senza pretraining mix. Gli autori chiamano la variante completa PPO-ptx, dove il suffisso indica proprio il termine sui dati di pretraining, e, salvo diversa indicazione, nel paper il nome «InstructGPT» si riferisce a questi modelli. PPO-ptx riduce sensibilmente le regressioni senza compromettere le preferenze espresse dagli annotatori, anche se non elimina del tutto le regressioni.
Il punto concettuale da portarsi via è che la penalità KL e il termine ptx agiscono su distribuzioni diverse. La KL trattiene la policy vicino al modello SFT sulle risposte generate per i prompt incontrati durante PPO. Il termine ptx, invece, fornisce un segnale diretto sui dati di pretraining e aiuta a preservare capacità che PPO non esercita.
Aumentare può limitare maggiormente lo spostamento della policy, ma non equivale a ripassare quelle capacità. Negli esperimenti del paper sul modello da 1,3 miliardi di parametri, persino un valore di cento volte superiore a quello predefinito non recupera completamente le prestazioni su DROP e SQuAD e riduce sensibilmente il reward di validazione. Restare più vicini al modello SFT sui prompt di PPO non equivale a continuare ad allenarsi sulla distribuzione più ampia da cui provengono le sue capacità.
Il quadro d'insieme
A questo punto tutti i componenti sono sul tavolo. Visti uno alla volta, i tre stadi sembrano tre tecniche indipendenti. Messi in fila, fanno una cosa sola.
Il primo stadio imposta il comportamento da assistente e rende praticabile quello successivo. PPO riceve un segnale diretto soltanto sulle risposte che la policy riesce a campionare: se quelle utili sono estremamente rare, compariranno troppo poco perché il reward possa fornire un segnale efficace. L'SFT le rende abbastanza probabili da poter essere esplorate e affinate. Non è una necessità matematica assoluta, ma il punto di partenza che porta il modello nella regione di comportamento in cui l'RL può lavorare.
Il secondo stadio costruisce il giudice. Durante PPO bisogna valutare un numero enorme di risposte, una scala impraticabile se ciascuna valutazione richiede l'intervento di una persona. Il reward model è, in un certo senso, giudizio umano compilato: gli annotatori esprimono le proprie preferenze su un insieme limitato di esempi, il modello impara ad approssimarle e quell'approssimazione può poi essere applicata automaticamente a molte più risposte. Non significa che le persone intervengano una volta sola: il giudice può essere aggiornato raccogliendo nuovi confronti dalle policy più recenti.
Il terzo stadio redistribuisce le probabilità. Nella componente PPO, la policy genera le proprie risposte, il giudice le valuta e i pesi vengono aggiornati per rendere più probabili le scelte che hanno ottenuto un advantage positivo e meno probabili quelle valutate peggio. A differenza del fine-tuning supervisionato, non esiste una risposta bersaglio da imitare: il reward non mostra al modello che cosa avrebbe dovuto scrivere, ma assegna un punteggio a ciò che ha scritto. Nel PPO-ptx usato per InstructGPT, a questo segnale si aggiungono comunque i gradienti calcolati sui dati di pretraining.
Da qui una sintesi utile, purché non la si prenda alla lettera: in InstructGPT, l'RLHF serve soprattutto a far emergere e rendere più accessibili comportamenti che il pretraining aveva già reso possibili, più che ad aggiungere nuova conoscenza generale. Questo non significa che il fine-tuning non insegni nulla: modifica i pesi, apprende nuove convenzioni di comportamento e può generalizzare a istruzioni mai viste.
È anche il senso del risultato più sorprendente del paper: sui prompt valutati, un InstructGPT da 1,3 miliardi di parametri viene preferito a un GPT-3 non allineato da 175 miliardi. Non significa che i due modelli possiedano le stesse conoscenze. Mostra che, su quella distribuzione di prompt, il modo in cui le capacità vengono rese disponibili può contare più della sola scala.
C'è infine un filo comune che attraversa tutti e tre gli stadi. A ogni livello si ottimizza una misura imperfetta di ciò che interessa davvero, e ogni misura lascia fuori qualcosa. La cross-entropy dell'SFT, cioè la loss del primo stadio, misura quanta probabilità il modello assegna, token dopo token, alle specifiche dimostrazioni raccolte; non rappresenta la qualità di tutte le possibili risposte valide. Nell'esperimento, infatti, la loss di validazione peggiora mentre il punteggio del reward model e le preferenze umane migliorano, e gli autori scelgono il checkpoint mediante il reward model.
Il reward model, a sua volta, approssima le preferenze degli annotatori e può avere regioni nelle quali sbaglia: per questo la penalità KL riduce il rischio di spingere la policy troppo lontano dalla regione in cui il giudice è affidabile. E quelle preferenze non coincidono con una misura universale di «risposta buona»: riflettono le istruzioni, i criteri, la composizione e i disaccordi di uno specifico gruppo di persone.
Tutto l'RLHF sta in questo equilibrio: spingere l'ottimizzazione abbastanza da migliorare il modello, ma non tanto da trasformare i limiti delle sue approssimazioni in scorciatoie da sfruttare.