RLHF — Instruction tuning e chat template
In questo post ci immergiamo un po’ più nel dettaglio in ciò che riguarda l’Instruction Fine Tuning — detto anche Instruction Tuning. Questo è il metodo di base per adattare i modelli di linguaggio ad una determinata distribuzione di task. Rappresenta il punto di partenza per RLHF preparando il modello ad un formato di istruzioni conosciuto come “question-answering”.
Questo è un metodo “supervised”, il che significa che necessita di esempi che contengono la risposta desiderata, le “etichette”: scritte da persone o, come vedremo, generate da altri modelli. Di seguito vedremo più nel dettaglio come questo metodo di training viene gestito e come i dati di training sono formattati e strutturati.
Un modello che completa sequenze
Partiamo dall’inizio. Come abbiamo visto, un modello linguistico di base è addestrato a eseguire una sola operazione: data una sequenza di token, stimare quale token dovrebbe venire dopo.
Il modello infatti non nasce come chatbot e non possiede inizialmente il concetto di conversazione.
Se il modello riceve una frase incompleta come “The capital of the United States is” il modello potrebbe continuare generando “Washington”. Dal suo punto di vista, però, non ha risposto ad una domanda. Ha soltanto completato una sequenza sulla base delle regolarità apprese durante il pre-training. In termini probabilistici, dato un insieme di token precedenti, il modello calcola la probabilità dei possibili token successivi: è proprio la (1).
Probabilmente dirò qualcosa di scontato, ma quando ci riferiamo al “token” indichiamo l’unità elementare
elaborata dal modello. Prima di essere ricevuto dal Transformer, il testo viene analizzato da un
tokenizer, un modulo ad hoc che lo suddivide in frammenti e assegna a ciascuno un identificatore
numerico. Ogni frase viene quindi tradotta in una sequenza di token che il modello elabora. Esistono
inoltre dei token con funzioni speciali: <bos_token>, ad esempio, può indicare l’inizio di una
sequenza, mentre <eos_token> può segnalarne la conclusione. Il nome concreto cambia da modello a
modello: <s> e </s>, per esempio, oppure <|begin_of_text|> e <|end_of_text|>.
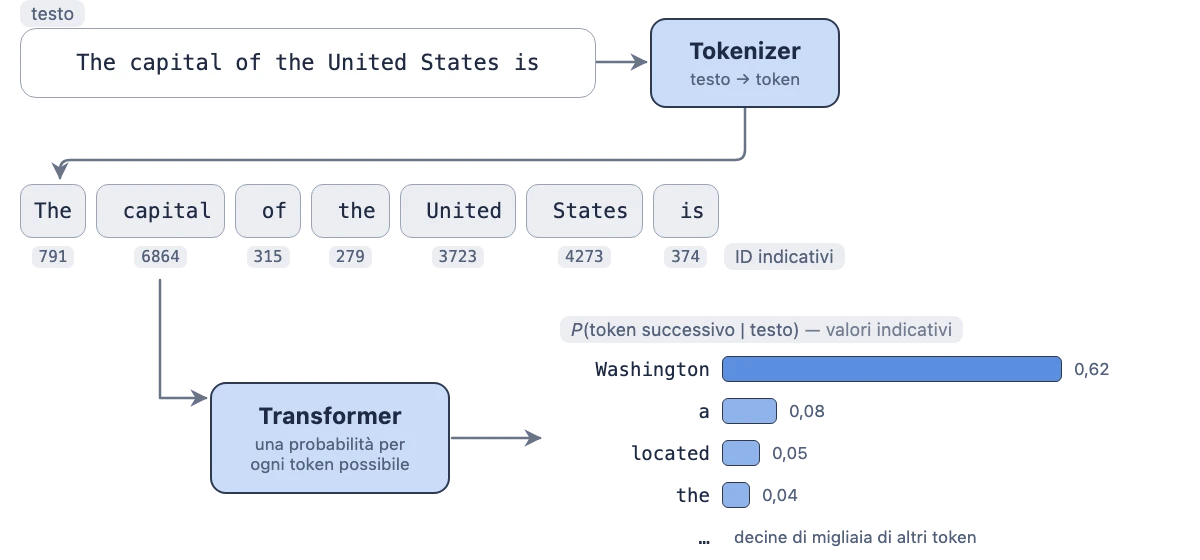
In quest’ottica, interagire con un modello significa fornirgli un testo da completare, ad esempio:
<bos_token>The capital of the United States is
Il modello continua a generare token finché non produce un token di fine sequenza, raggiunge un limite imposto dall’applicazione oppure esaurisce la propria finestra di contesto.
Il chat template
Come si trasforma quindi un modello del genere in un assistente? Le applicazioni rappresentano una conversazione attraverso strutture dati, ma il modello, come abbiamo appena visto, continua ad accettare soltanto sequenze di token.
Un’applicazione potrebbe ad esempio rappresentare una conversazione in questo modo:
messages = [
    {
        "role": "system",
        "content": "Sei un assistente esperto di reti."
    },
    {
        "role": "user",
        "content": "Che cos'è il protocollo TCP?"
    }
]
Come vediamo, sono presenti una lista, due dizionari, dei campi e una separazione esplicita tra ruoli e contenuti. È necessaria una conversione da oggetti Python a una singola sequenza testuale che sia successivamente tokenizzata.
Introduciamo quindi il Chat Template.
Il Chat Template rappresenta una regola di serializzazione. Stabilisce in che ordine disporre i messaggi, come indicare i ruoli, quali delimitatori inserire e come indicare al modello che deve iniziare a generare la risposta dell’assistente. Un esempio di template è ChatML: seguendo la sua struttura, la conversazione riportata nell’ultimo esempio diventa:
<|im_start|>system
Sei un assistente esperto di reti.<|im_end|>
<|im_start|>user
Che cos'è il protocollo TCP?<|im_end|>
<|im_start|>assistant
I marcatori <|im_start|> e <|im_end|> delimitano i singoli messaggi: sono token speciali, ciascuno
con un proprio identificatore, non testo qualunque. Le parole system, user e assistant
identificano invece il ruolo associato a ciascun contenuto.
Il ruolo system contiene normalmente istruzioni generali sul comportamento desiderato. Può chiedere al modello di rispondere in una determinata lingua, adottare uno stile, rispettare alcuni vincoli o interpretare uno specifico ruolo.
La parte finale della sequenza rimane incompleta intenzionalmente: il modello la tratta come il punto di partenza da cui generare il token successivo, cioè l’inizio della risposta dell’assistente.
Più turni, una sola sequenza
È importante tenere in considerazione questa struttura soprattutto nei contesti in cui la conversazione contiene più turni. Immaginiamo il seguente dialogo:
Utente: Cos'è TCP?
Assistente: È un protocollo di trasporto affidabile.
Utente: Cosa significa affidabile?
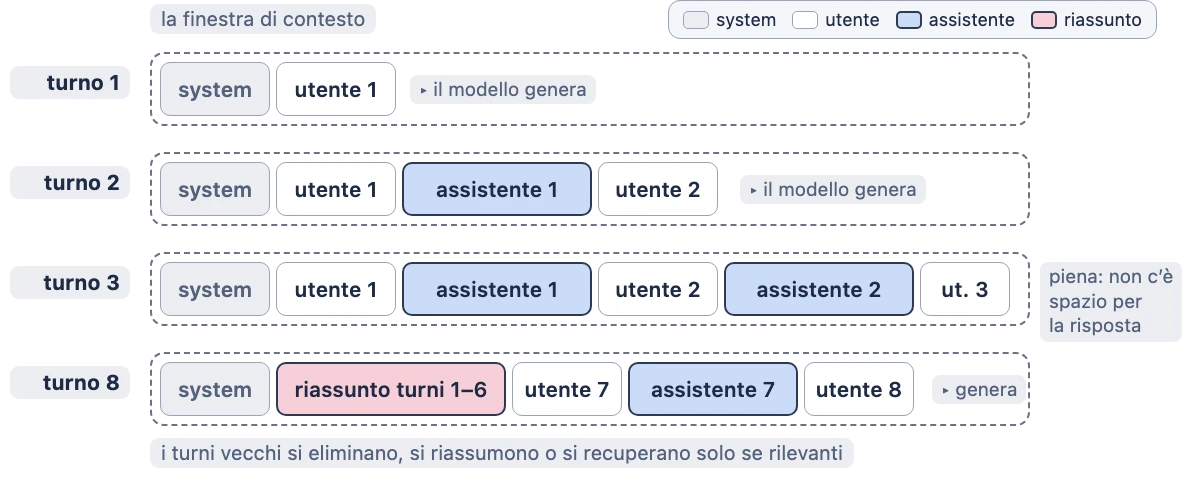
Per rispondere all’ultima domanda, il modello deve conoscere il contenuto degli scambi precedenti. Viene dunque ricostruita l’intera cronologia rilevante:
<|im_start|>user
Cos'è TCP?<|im_end|>
<|im_start|>assistant
È un protocollo di trasporto affidabile.<|im_end|>
<|im_start|>user
Cosa significa affidabile?<|im_end|>
<|im_start|>assistant
Vediamo in questo esempio semplificato che la memoria conversazionale non è quindi una memoria permanente conservata internamente dal modello. È la cronologia, ripresentata ogni volta all’interno della sequenza di input. Questo comporta un limite naturale. Ogni modello dispone di una finestra di contesto finita. Quando la conversazione diventa troppo lunga, non è più possibile reinserire indefinitamente tutti i messaggi precedenti. L’applicazione deve allora scegliere quali eliminare, quali riassumere e quali recuperare perché rilevanti per la richiesta corrente.
L’addestramento
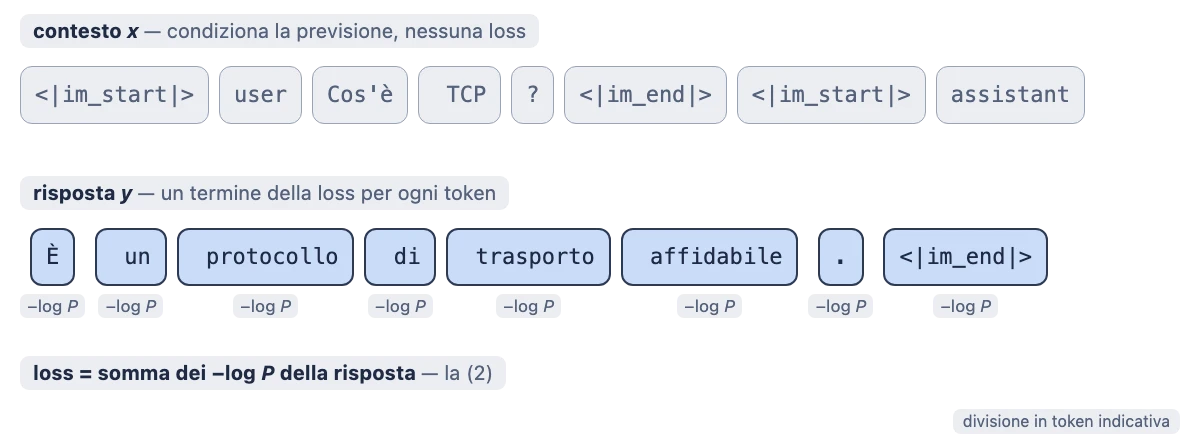
Abbiamo visto quindi la struttura che viene utilizzata sui dati di training di questa fase. Quasi “tutto qua”. Il processo di training è lo stesso usato nella fase di pre-training, attraverso la predizione del token successivo. In molti sistemi, tuttavia, la funzione di errore viene calcolata principalmente o esclusivamente sui token della risposta dell’assistente. Il contesto formato dalle istruzioni e dalla domanda serve a condizionare la previsione, mentre il modello viene corretto in base a quanta probabilità assegna, token dopo token, alla risposta di riferimento.
In maniera semplificata, la funzione di errore da minimizzare può essere espressa come:
Qui rappresenta il prompt formattato, è il token corretto della risposta, contiene i token della risposta già osservati e rappresenta i parametri del modello, con la stessa lettera dei post precedenti.
Ripetendo il processo su numerosi esempi, il modello impara progressivamente che il contenuto associato
al ruolo system fornisce istruzioni generali, che il contenuto user rappresenta una richiesta e che, dopo
l’apertura di un turno assistant, dovrebbe produrre una risposta coerente. Impara inoltre che
<|im_end|> segnala normalmente la conclusione del messaggio.
Le fasi successive del post-training, come il preference tuning o il reinforcement learning basato sul feedback umano, possono modificare la qualità e lo stile delle risposte, ma continuano generalmente a utilizzare una struttura conversazionale compatibile.
Il template come protocollo
Il template utilizzato durante l’inferenza dovrebbe corrispondere a quello usato durante il post-training. Se un modello è stato addestrato con delimitatori come:
<|im_start|>user
...
<|im_end|>
ma durante l’utilizzo riceve un formato completamente diverso:
### Human:
...
### Bot:
potrebbe ancora riuscire a rispondere, perché riconosce il contenuto linguistico, ma potrebbe farlo in modo meno stabile o con prestazioni inferiori. Il formato funziona come una sorta di protocollo applicativo: il significato generale può essere simile, ma il modello è stato ottimizzato per riconoscere una specifica codifica.
Esistono diversi template, che variano più nella sintassi che nel principio.
Una volta stabilito questo meccanismo, è possibile estenderlo oltre la semplice conversazione. Lo stesso formato può rappresentare, per esempio, l’utilizzo di strumenti esterni. Se l’utente domanda quale sia il tempo a Roma, il modello può generare una struttura che esprime la volontà di chiamare un servizio meteorologico (i delimitatori sono illustrativi: ogni famiglia di modelli definisce i propri):
<|tool_call|>
{"name":"weather","arguments":{"city":"Rome"}}
<|tool_end|>
Il modello, normalmente, non esegue direttamente il servizio. È l’applicazione (il software che si trova tra l’utente e il modello linguistico) che intercetta la richiesta, invoca lo strumento reale e reinserisce il risultato nella conversazione:
<|tool_result|>
{"temperature":22,"condition":"sereno"}
<|tool_end|>
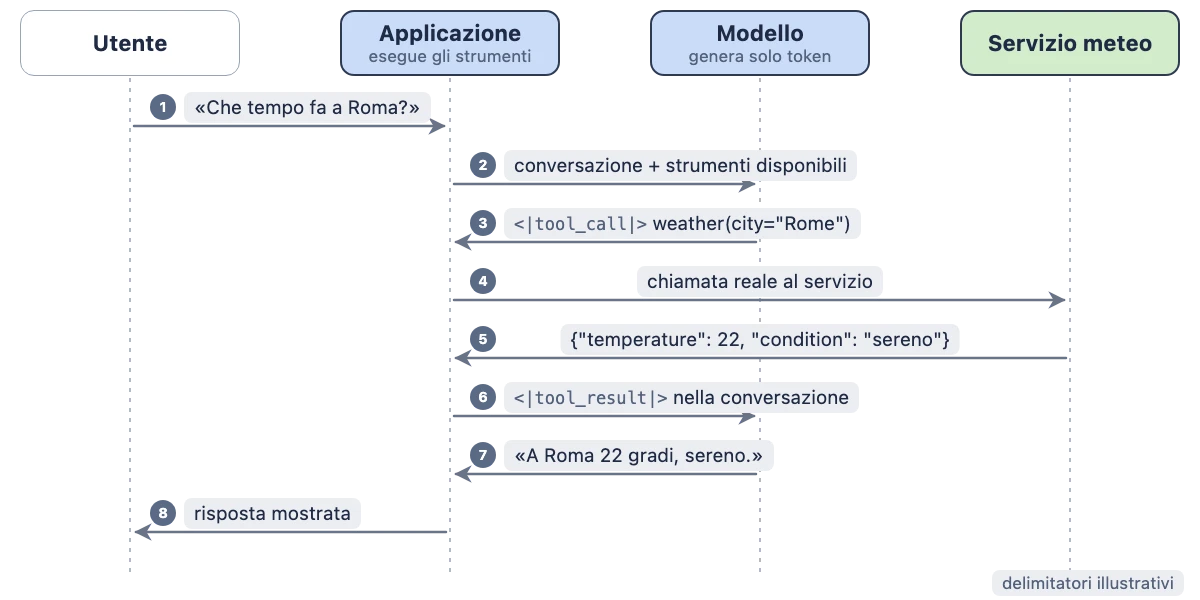
Vediamo dunque che non è cambiato il modo in cui il modello funziona, quanto la struttura con cui l’informazione è rappresentata.
Il flusso completo può essere riassunto così: l’applicazione raccoglie una conversazione strutturata, il chat template la trasforma in una stringa contenente ruoli e delimitatori, il tokenizer converte quella stringa in identificatori numerici, il Transformer prevede i token successivi e l’applicazione interpreta i token generati come una risposta dell’assistente.
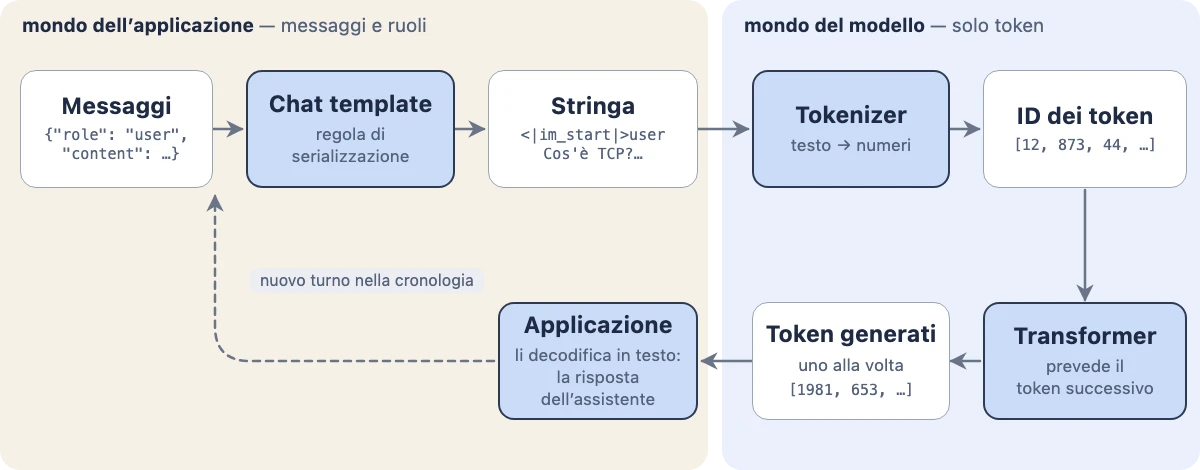
Il chat template è quindi il ponte tra due rappresentazioni profondamente diverse. Da un lato esiste il mondo dell’applicazione, nel quale si parla di utenti, assistenti, messaggi, cronologia e strumenti. Dall’altro esiste il mondo matematico del modello, nel quale esistono soltanto sequenze di token e probabilità condizionate. Il chat template rende possibile il passaggio dal primo al secondo mondo e, attraverso il post-training, permette a un semplice completatore di testo di comportarsi come un assistente conversazionale.
I dati
Abbiamo visto dunque il formato che i dati devono avere per rendere una sequenza comprensibile dal modello. Ora, la capacità del modello di rispondere in maniera utile, dunque di generare una serie di token nel formato appena visto e con un valore nella risposta data, deriva dall’Instruction Tuning, cioè la fase di addestramento supervisionato che abbiamo anticipato all’inizio.
In questa fase, il modello riceve il prompt iniziale, che utilizza come contesto per prevedere, token dopo token, la risposta di riferimento, sulla quale viene poi calcolata la loss. Dunque vediamo che è soprattutto la qualità delle risposte di addestramento a determinare il risultato finale.
Grazie a metodi come LoRA (Low-Rank Adaptation), che mantiene invariati i pesi originali del modello e addestra solo piccole matrici aggiuntive (gli adapter), e alla quantizzazione, che riduce la memoria occupata dai pesi e che QLoRA combina con LoRA, l’Instruction Tuning diventa accessibile anche senza l’infrastruttura necessaria per riaddestrare integralmente un grande modello.
A questo punto, quanti dati servono per ottenere un buon risultato?
La risposta dipende dalla distanza tra le capacità già presenti nel modello e il comportamento che si desidera insegnare. Se l’obiettivo è circoscritto, un dataset piccolo ma accuratamente selezionato può produrre risultati molto buoni. Un modello pre-addestrato possiede già una grande quantità di conoscenze linguistiche e fattuali; l’instruction tuning non deve necessariamente insegnargli tutto da zero. Può limitarsi a mostrargli come utilizzare ciò che già conosce nel formato e nello stile desiderati.
Questo principio è particolarmente evidente nei compiti di chat alignment. Se si vuole insegnare al modello a rispondere in modo disponibile, coerente e conversazionale, senza introdurre capacità complesse completamente nuove, poche migliaia di esempi di alta qualità possono essere molto efficaci.
Dataset come LIMA, circa mille esempi, hanno mostrato che una raccolta relativamente piccola e accuratamente curata può modificare sensibilmente il comportamento conversazionale di un modello. Circa un anno dopo la diffusione di ChatGPT, dataset umani come No Robots, costituiti da circa diecimila esempi, rappresentavano un riferimento importante per l’addestramento di assistenti open source.
Quando però si cercano obiettivi più ambiziosi (non solo una conversazione gradevole, ma anche la capacità di risolvere problemi matematici, scrivere codice, seguire istruzioni complesse, utilizzare strumenti, produrre output strutturati e operare in domini specialistici) sono necessari dataset molto più grandi, composti da centinaia di migliaia o milioni di esempi.
Il collo di bottiglia diventa quindi la costruzione di questi dataset. Una soluzione la si trova ricorrendo all’utilizzo di modelli linguistici più “capaci” per generare un dataset sintetico (filtrando e verificando in maniera opportuna).
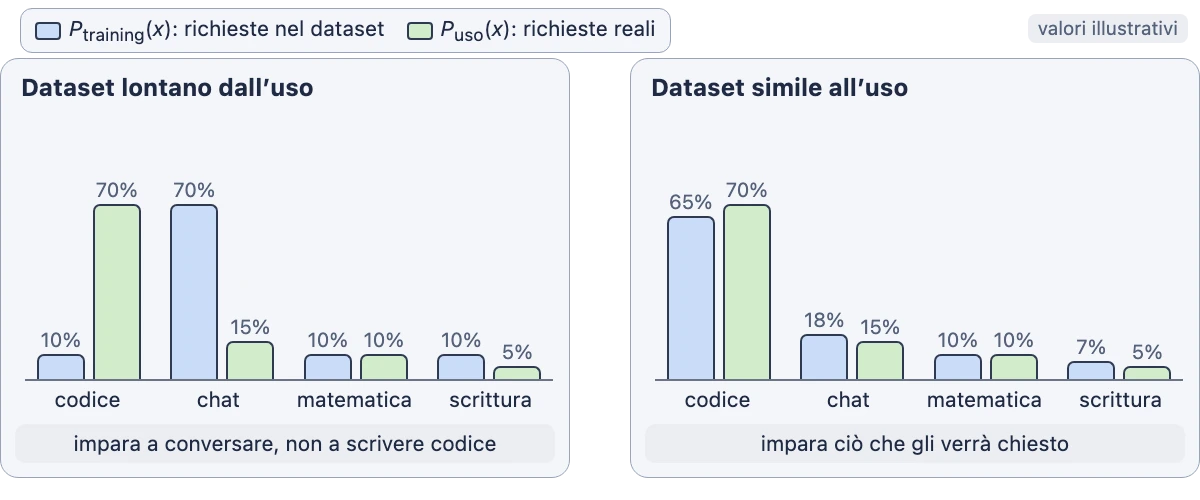
Nella progettazione di un dataset occorre inoltre considerare la distribuzione dei prompt. Se il modello verrà utilizzato principalmente per assistere programmatori, dovrebbe vedere richieste simili a quelle che incontrerà in produzione: debugging, spiegazione di errori, generazione di test, modifica del codice e analisi di architetture software.
Addestrarlo prevalentemente su conversazioni generiche potrebbe migliorarne la capacità di dialogo, ma non prepararlo adeguatamente al lavoro sul codice. Allo stesso modo, un dataset quasi interamente matematico non è la scelta migliore per costruire un assistente destinato alla scrittura creativa.
Il principio può essere espresso, in modo informale, come una corrispondenza tra distribuzioni:
dove rappresenta la distribuzione delle richieste presenti nel dataset e quella delle richieste che il modello riceverà realmente. Quanto più queste distribuzioni sono simili, tanto più il comportamento appreso durante il training risulterà pertinente nell’utilizzo successivo.
Una fase fra le altre
Ricordiamoci però che il post-training non è generalmente composto da un’unica fase isolata. Dopo l’instruction tuning possono seguire il preference tuning, RLHF, metodi di ottimizzazione diretta delle preferenze, training specifici per il ragionamento o ulteriori adattamenti di dominio.
Se alcuni esempi sono imperfetti all’interno del dataset di instruction tuning, le fasi successive possono correggere parte dei comportamenti indesiderati, purché il segnale complessivo rimanga valido.
Ciò non significa che la qualità dei dati possa essere ignorata. Significa piuttosto che l’obiettivo non è rendere ogni singola fase perfetta indipendentemente dalle altre. Bisogna progettare l’intero processo di ottimizzazione affinché le diverse fasi collaborino verso il comportamento finale desiderato.
L’instruction tuning costituisce così il primo passaggio nel quale un modello pre-addestrato impara sistematicamente a interpretare il testo come un’istruzione e a produrre una risposta appropriata. Il chat template gli fornisce la grammatica della conversazione; il dataset gli mostra il comportamento da adottare; la funzione di loss trasforma la distanza tra ciò che il modello si aspettava e la risposta desiderata in aggiornamenti dei parametri; le fasi successive perfezionano infine quel comportamento sulla base delle preferenze e degli obiettivi del sistema.
Il risultato non è un modello che ha cessato di prevedere token. È un modello per il quale, dopo una richiesta formulata nel corretto contesto conversazionale, le continuazioni più probabili sono diventate risposte utili, pertinenti e strutturate.